Configuración
La página Settings es la superficie de configuración del tenant. Una navegación lateral izquierda enumera cada sección; el panel derecho muestra el editor de la sección seleccionada. La mayoría de las secciones son solo para administradores; la sección Profile está disponible para todos los usuarios.
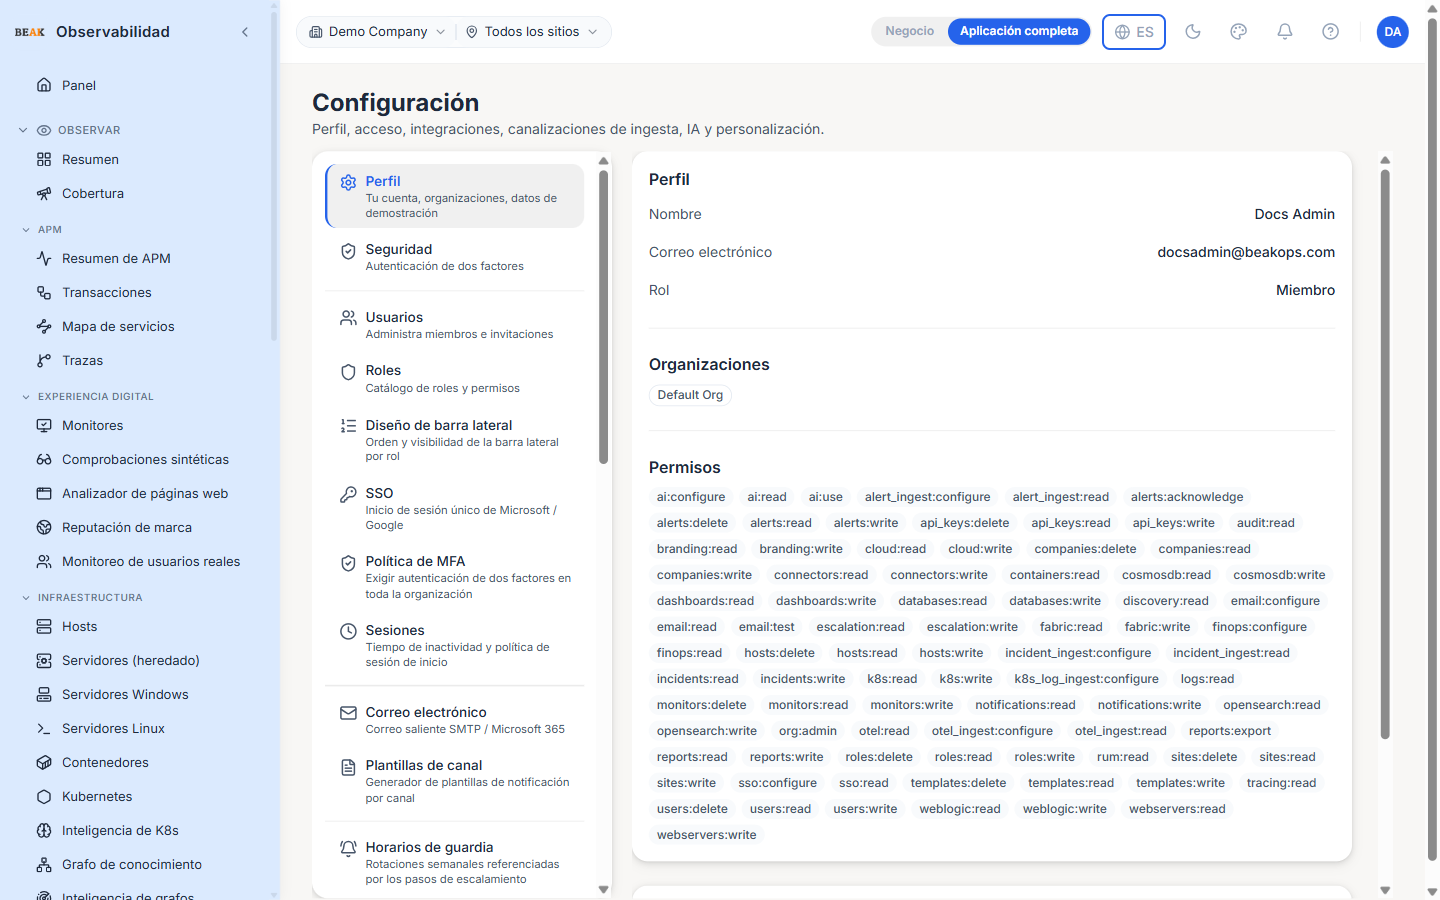
Secciones
La configuración está agrupada en temas:
Cuenta
- Profile — Los detalles de su cuenta, las organizaciones a las que pertenece y las herramientas de datos de demostración
Acceso
- Users — Gestionar miembros e invitaciones
- Roles — Roles y el catálogo de permisos
- Sidebar layout — Orden y visibilidad de la barra lateral por rol (el orden guardado se aplica sobre la barra lateral predeterminada)
- SSO — Inicio de sesión único de Microsoft / Google
- Security — Inscribir y gestionar su propia autenticación de dos factores (2FA / TOTP) para el inicio de sesión
- MFA Policy — Requerir autenticación de dos factores en toda la organización, de modo que cada miembro deba inscribirse en 2FA antes de acceder
- Sessions — Política de sesión de inicio de sesión: tiempo de espera inactivo, duración absoluta de la sesión, límite de sesiones simultáneas y comportamiento de inicio de sesión persistente
Comunicaciones
- Email — Configuración de correo saliente SMTP / Microsoft 365
- Channel Templates — Constructor de plantillas de notificación por canal
Operaciones
- On-call schedules — Rotaciones semanales referenciadas por pasos de escalamiento de alertas
- RCA weights — Ajuste por organización de los componentes de puntuación de RCA
- Maintenance windows — Silenciamiento con conocimiento de topología para trabajos planificados
- Service ownership — Asignación dinámica de equipos con anulaciones fijas
- Team routing — Enrutar alertas a los canales del equipo propietario, con presupuestos de ruido por equipo
- SLOs — Definir objetivos de nivel de servicio y realizar seguimiento del consumo del presupuesto de error
- Action policies — Gobernar acciones de remediación — ejecución automática, requerir aprobación o denegar
Pipelines de ingesta
- Alert Ingest — Alertas entrantes de Splunk, Datadog y otras fuentes externas
- OTel Ingest — Trazas, métricas y registros de OpenTelemetry
- Incident Ingest — Incidentes entrantes de PagerDuty, Jira, ServiceNow, Opsgenie, Statuspage
Ingesta multi-empresa y multi-sitio
Una clave de API de Alert Ingest o Incident Ingest creada sin una empresa (una clave "de ámbito de organización") puede enviar datos a cualquier empresa de la organización nombrando la empresa de destino — y opcionalmente un sitio — en cada solicitud. Una integración puede entonces atribuir alertas e incidentes a la empresa/sitio correcto sin necesidad de una clave separada por ámbito.
- Encabezado de empresa (preferido) —
X-Company-ID: <company-id> - Parámetro de consulta de empresa (alternativo) —
?company_id=<company-id> - Encabezado de sitio (preferido) —
X-Site-ID: <site-id> - Parámetro de consulta de sitio (alternativo) —
?site_id=<site-id>
Cuando se proporcionan tanto un encabezado como un parámetro, el encabezado tiene precedencia. La empresa debe pertenecer a la organización de la clave y el sitio a esa empresa; de lo contrario, la solicitud es rechazada. Omitir el sitio registra la fila en la empresa sin sitio — permanece visible bajo la opción All sites del selector de ámbito.
Nota: Una clave creada con una empresa (o sitio) queda vinculada a ella e ignora cualquier encabezado
X-Company-ID/X-Site-IDo parámetrocompany_id/site_iden la solicitud. Utilice una clave de ámbito de organización para la ingesta multi-empresa o multi-sitio.
El mismo ámbito de empresa y sitio también se aplica a las listas de lectura — la lista de alertas ingeridas en la página Alerts y la lista de incidentes recibidos ambas filtran por la empresa y el sitio seleccionados.
Recuperar y actualizar registros ingeridos
Las alertas e incidentes ingeridos pueden recuperarse y actualizarse con la misma clave de API de ingesta, de modo que un agente de IA — o cualquier integración — pueda extraer el historial y escribir los resultados del triaje de vuelta. Envíe la clave en el encabezado X-API-Key.
- Listar —
GET /api/v1/alert-ingest/alerts,GET /api/v1/incident-ingest/incidents - Obtener uno —
GET /api/v1/alert-ingest/alerts/{id},GET /api/v1/incident-ingest/incidents/{id} - Actualizar uno —
PUT /api/v1/alert-ingest/alerts/{id},PUT /api/v1/incident-ingest/incidents/{id}
{id} acepta el UUID o el id de visualización legible AL-… / INC-…. El ámbito de la clave Alert Ingest ya otorga lectura y actualización de alertas; el ámbito Incident Ingest hace lo mismo para los incidentes. También se aceptan ámbitos de solo lectura y escritura más granulares.
La lista de alertas también acepta un parámetro de consulta event_source — una coincidencia exacta con el sistema fuente upstream integrado en el custom_data.source de la alerta. Esto es distinto de source (el canal proveedor de Beak, por ejemplo generic / manageengine): una integración que canaliza muchos sistemas upstream a través de un canal puede almacenar el id del sistema real en custom_data y filtrar por él aquí. Por ejemplo GET /api/v1/alert-ingest/alerts?event_source=GUI_gestioneventos.
Un PUT aplica solo un conjunto fijo de campos — cualquier otro campo en el cuerpo es ignorado, por lo que un registro nunca puede ser asignado masivamente:
- Alerta —
status,severity,acknowledged_at,resolved_at,snoozed_until,custom_data,note(agrega una nota de triaje) yresolution_note. - Incidente —
status,severity,priority,assignee,service_name,title,description,acknowledged_at,resolved_at,closed_at,custom_data,rca_narrativeyresolution_note.
Nota: Una
resolution_notees obligatoria siempre que unPUTtransite un registro aresolved(status: "resolved") — una nota ausente o en blanco es rechazada con422. Registra por qué se cerró la alerta o el incidente y se muestra en el registro resuelto.
Nota: Cada lectura y actualización está limitada al ámbito de la organización de la clave — y a su empresa (y sitio), para una clave vinculada — por lo que una solicitud nunca puede acceder a los registros de otro tenant, empresa o sitio.
Recuperar y actualizar registros no ingeridos
Las alertas disparadas por reglas (el motor de alertas interno) y los incidentes del motor de reglas también son accesibles mediante una clave de API, usando el mismo encabezado X-API-Key:
- Listar —
GET /api/v1/alerts(el feed unificado — disparado por reglas e ingerido),GET /api/v1/promoted-incidents - Obtener uno —
GET /api/v1/alerts/{origin}/{id}(originruleoexternal),GET /api/v1/promoted-incidents/{id} - Actualizar uno —
PUT /api/v1/alerts/{origin}/{id},PUT /api/v1/promoted-incidents/{id}
Estos requieren los ámbitos alerts:read_internal / alerts:write_internal e incidents:read_internal / incidents:write_internal (o el super-ámbito *). {id} acepta el UUID o el id de visualización. La lista blanca de PUT:
- Alerta —
status,severity,acknowledged_at,resolved_at,snoozed_until,note(agregar) yresolution_note. Para una alerta de origen externo, también se aceptanseverity_text/severity_number/custom_data. - Incidente —
status,severity,title,summary,acknowledged_at,resolved_at,closed_atyresolution_note.
Nota: Los endpoints dedicados de resolución
POST /api/v1/alerts/{origin}/{id}/resolveyPOST /api/v1/alert-groups/{id}/resolverequieren unaresolution_noteen el cuerpo (una nota en blanco genera un422). Al igual que con las rutasPUT, no se permite resolver sin una nota.
Nota: El estado de una alerta disparada por regla y el ciclo de vida de un incidente del motor de reglas son recalculados por el motor de evaluación, por lo que un estado forzado mediante
PUTpuede ser sobrescrito en el siguiente ciclo de evaluación. El reconocimiento / resolución / posponer y las notas son estables.
Inteligencia
- AI Settings — Proveedor de LLM, clave de API, selección de modelo y límites por tenant
- FinOps — Integración de producto de costos y enlaces profundos
Marca
- Branding — Nombre de la plataforma, logotipo, apariencia de la pantalla de inicio de sesión
Configuración de Empresa
Anulaciones por empresa para el comportamiento de la plataforma, limitadas a la empresa seleccionada en el selector de ámbito de la barra superior (solo para administradores). Cambie de empresa en el selector para configurar cada una. Cada anulación tiene tres estados: un valor explícito, o Inherit — recurrir al valor predeterminado de toda la organización para esa configuración cuando la empresa no ha establecido el suyo propio.
- AI incident promoter — Inherit (usar el valor predeterminado de la organización), Enabled o Disabled. Controla si las alertas recurrentes/críticas de reglas, de Kubernetes y de pronóstico de esta empresa se promueven automáticamente a incidentes. El valor predeterminado de la organización es desactivado, por lo que las críticas de una empresa que hereda permanecen en la página Alerts hasta que ella (o el valor predeterminado de la organización) opte por activarlo — consulte la nota del promotor en la página Incidents para el comportamiento completo. La pestaña muestra el valor efectivo resuelto, para que pueda ver a qué recurre actualmente Inherit.
Configuración de Plataforma
Parámetros de tiempo de ejecución para toda la organización (solo para administradores) — ventanas de retención, configuración de OpenSearch y ajustes similares — que se recargan en caliente, por lo que un cambio tiene efecto sin necesidad de reinicio.
Política de acceso
Las secciones de política de acceso controlan la autenticación y la seguridad de sesión para el tenant.
Security
Security es la sección personal de autenticación de dos factores y contraseña de cada usuario. Con 2FA habilitado, cada inicio de sesión solicita un código de 6 dígitos de su aplicación de autenticación; la página muestra su fecha de inscripción, cuándo se usó un código por última vez y cuántos de sus 10 códigos de respaldo quedan. Ofrece tres acciones:
- Regenerate backup codes — Emite un nuevo conjunto de 10 códigos e invalida todos los códigos anteriores (usados o no); requiere su código de 6 dígitos actual.
- Disable two-factor authentication — Desactiva MFA después de ingresar un código actual (sus códigos de respaldo también se eliminan). Si la Política de MFA de la organización requiere 2FA, no puede desactivarlo usted mismo — un administrador debe restablecer su MFA o cambiar la política.
- Change password — Actualiza su contraseña de inicio de sesión (se requiere la contraseña actual); no está disponible cuando inicia sesión mediante SSO.
MFA Policy
MFA Policy es el control de toda la organización detrás de Security — un único interruptor Require two-factor authentication. Cuando está activado, cada usuario que inicia sesión con correo electrónico + contraseña debe inscribirse en MFA antes de acceder al panel y no puede deshabilitar su propio MFA hasta que la política se desactive. Los usuarios de SSO se autentican a través del MFA de su proveedor de identidad y no se ven afectados por este interruptor.
Sessions
Sessions define la política de sesión de inicio de sesión aplicada a todos los usuarios de la organización, tanto en el navegador como en el servidor:
- Idle timeout (minutes) — Cierra la sesión del usuario después de esta cantidad de minutos sin actividad de ratón / teclado / desplazamiento; la actualización de datos en segundo plano no cuenta como actividad.
- Absolute session lifetime (hours) — Fuerza el inicio de sesión nuevamente después de esta cantidad de horas independientemente de la actividad; establezca
0para desactivar el límite absoluto. - Warning countdown (seconds) — Cuántos segundos antes del tiempo de espera inactivo se mostrará la advertencia "será desconectado"; debe ser menor que el tiempo de espera inactivo.
- Max concurrent sessions per user — Limita cuántos dispositivos / navegadores puede tener un usuario con sesión iniciada a la vez; la sesión más antigua termina cuando se supera el límite. Establezca
0para ilimitado. - Keep users signed in across browser restarts — Cuando está desactivado, cerrar el navegador termina la sesión; cuando está activado, la sesión se reanuda hasta que se agote el tiempo.
Save changes aplica la política; Reset revierte las ediciones no guardadas.
Fiabilidad y enrutamiento
Estas secciones determinan cómo llegan las alertas a los equipos y cómo se realiza el seguimiento y la remediación de la fiabilidad.
Team routing
Team routing asigna un equipo (resuelto por el resolvedor de propiedad) a un canal de notificación. Cuando está habilitado, el equipo propietario de una alerta activa es notificado en su canal además de los canales propios de la regla. Cada asignación toma un Team name, un Channel y un presupuesto Max pages / hour (0 = ilimitado) que limita la frecuencia con la que se notifica al equipo; las asignaciones guardadas aparecen en una tabla a continuación. Una herramienta Preview routing muestra a dónde se enrutaría una notificación para un servicio dado, junto con el rastro de resolución de propiedad detrás de ella.
SLOs
SLOs establece un objetivo de disponibilidad por servicio. El presupuesto de error es 100 − objetivo; el ejecutor calcula la tasa de consumo (1× consume exactamente el presupuesto) y el presupuesto restante a partir de la tasa de error medida del servicio. Cada SLO toma un Service, un Objective %, un Window (days) y un p95 target (ms) opcional, y la tabla de objetivos luego realiza el seguimiento del presupuesto restante y el consumo actual por servicio. Estos objetivos alimentan las vistas de SLO y presupuesto de error en las superficies Graph Intelligence y Predictions & Intelligence.
Action policies
Action policies gobiernan cómo se aplica cada tipo de remediación automatizada desde un incidente. Cada tipo de remediación — Restart pod, Scale up, Scale down, Rollback, Config change, Documented runbook y Manual / other — tiene su propia configuración de gobernanza. Los tipos no configurados tienen como valor predeterminado requires approval: nada se aplica automáticamente a menos que usted opte explícitamente por un tipo, de modo que las correcciones de bajo riesgo pueden auto-resolverse mientras que el resto mantiene a un humano en el proceso.
Navegación
La URL lleva la sección activa como /settings/<section>. Compartir un enlace a una sección específica funciona directamente. La lista de secciones mostradas a un usuario no administrador se filtra a aquellas para las que el usuario tiene permiso de visualización — Profile siempre es visible.
Carga diferida
El editor de cada sección se carga solo cuando se selecciona. Cambiar entre secciones es ágil incluso cuando los editores son pesados (por ejemplo, el catálogo de Roles).
Mejores prácticas
- Configure SSO y Roles antes de agregar usuarios humanos — las invitaciones funcionan de cualquier manera, pero las asignaciones de roles preexistentes evitan que los nuevos miembros queden con el rol predeterminado
Read-only. - El editor de Sidebar layout es el lugar correcto para ocultar entradas de menú que no utiliza — ocultarlas aquí es más limpio que pedirle al equipo que las ignore.
- Configure los On-call schedules antes de escribir políticas de escalamiento — las políticas hacen referencia a los horarios por ID y un horario faltante silenciará el paso de escalamiento.
- La sección Branding es global; los cambios afectan a todos los usuarios de inmediato. Pruebe en un tenant que no sea de producción primero si sus clientes ven la pantalla de inicio de sesión.
Páginas relacionadas
- Alerts — Canales de notificación y escalamientos que consumen horarios de guardia
- Connectors — Configuración por fuente que complementa la configuración de ingesta del tenant
- Admin — Claves de API, registro de auditoría y SSO a nivel de administrador