Microsoft Fabric Observability
El menú Fabric es el espacio dedicado de Beak para Microsoft Fabric. Conecte un tenant de Fabric con un service principal de solo lectura y Beak descubrirá sus capacidades, espacios de trabajo y elementos — pipelines de datos, notebooks, trabajos de Spark, dataflows, modelos semánticos, lakehouses, almacenes, eventhouses, bases de datos KQL, informes y paneles — crea un monitor por recurso, sondea el historial de ejecuciones y actualizaciones según una programación, y genera alertas sobre fallos.
Todo lo específico de Fabric reside aquí: la página genérica de Cloud ya no ofrece Fabric como proveedor conectable. El menú se lee de arriba a abajo tal como lo haría un operador — estado de la flota, luego qué requiere atención, luego un punto de lanzamiento hacia cada sección especializada.
Requisitos previos
Beak se autentica en Fabric como un service principal (SP) de Entra ID y únicamente lee — ninguna llamada a la API de Fabric que realiza Beak muta el estado. El secreto de cliente del SP se cifra en reposo y no se puede recuperar desde la interfaz de usuario una vez introducido.
Se admiten dos modelos de acceso, y Beak detecta cuál tiene en cada sincronización:
- Cobertura del tenant completo (Opción A) — El SP puede llamar a las APIs de administración de solo lectura. El descubrimiento recorre todo el tenant en tres llamadas y lo ve todo, incluyendo capacidades, gateways y registros de actividad.
- Ámbito de espacio de trabajo (Opción B, mínimos privilegios) — El SP se añade como
Vieweren cada espacio de trabajo que desee supervisar, y nada más. El descubrimiento enumera únicamente esos espacios de trabajo y sus elementos.
La Opción B es la solicitud menor y la que la mayoría de los clientes aprueban. Su única concesión es la cobertura: el estado de los gateways locales y los registros de actividad de Power BI son superficies exclusivas de administrador sin equivalente en el ámbito de espacio de trabajo, y un espacio de trabajo al que no se haya añadido el SP es invisible.
Lo que concede el administrador de Fabric:
- Registro de aplicación con secreto de cliente — Requerido para ambas opciones. Entregue
tenant_id,client_idyclient_secreta quien conecte la cuenta en Beak. - Los service principals pueden usar las APIs de Fabric — Configuración de tenant del portal de administración de Fabric, aplicada a un grupo de seguridad que contenga el SP. Obligatorio para ambas opciones.
Tenant.Read.All(Power BI Service, Application) con consentimiento de administrador — Solo para la Opción A.- Los service principals pueden acceder a las APIs de administrador de solo lectura — Solo para la Opción A. Esta es una segunda configuración de tenant independiente en el mismo panel de configuración de desarrollador; habilitar solo la primera y esperar un descubrimiento del tenant completo es el error de incorporación más habitual.
Vieweren el espacio de trabajo — La concesión principal de la Opción B, y en la Opción A la forma de desbloquear sondeos del plano de datos por elemento.
Nota: Permita aproximadamente quince minutos para la propagación de la configuración del tenant de Fabric antes de que se espere que la primera sincronización tenga éxito.
Las concesiones opcionales desbloquean superficies más profundas y se tratan en Mapa de acceso y capacidades. Beak degrada de forma limpia cuando falta alguna — el sondeo afectado informa de un error descriptivo y la pantalla indica qué concesión lo soluciona, sin fallos en cascada.
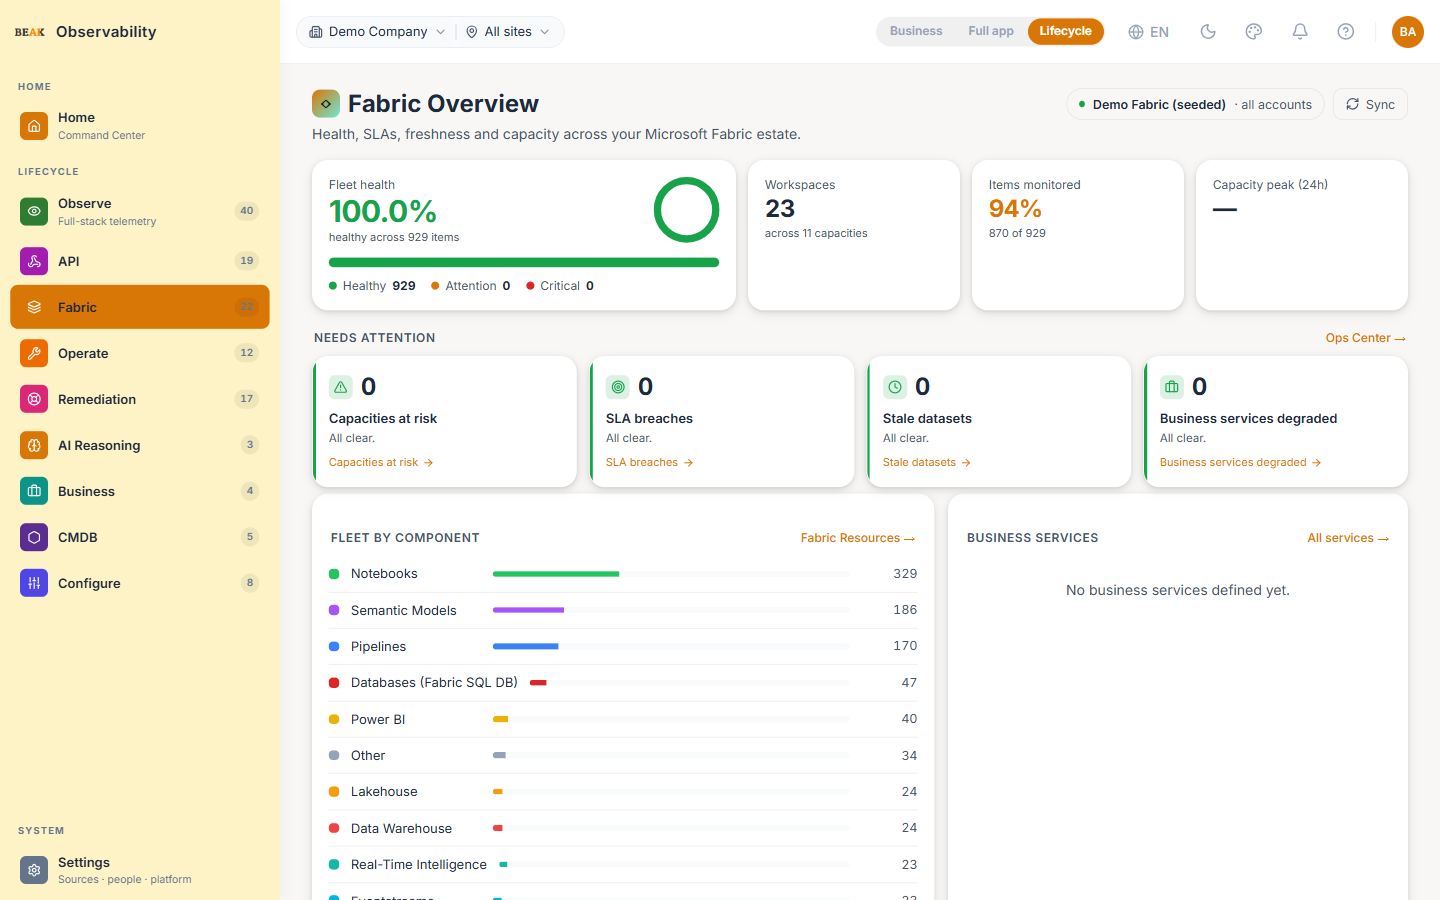
Fabric Overview
El centro de mando del entorno y la página de inicio del menú. Se lee en cuatro bandas:
- Estado de la flota — Correcto / atención / crítico en todos los elementos de Fabric supervisados, con el recuento de elementos correctos sobre el total
- Espacios de trabajo — Número de espacios de trabajo, distribuidos entre cuántas capacidades
- Elementos supervisados — Cuántos elementos descubiertos tienen un monitor asociado, del total
- Pico de capacidad (24h) — La utilización de capacidad más alta vista en el último día
Debajo de los mosaicos:
- Requiere atención — Capacidades en riesgo, incumplimientos de SLA, datasets obsoletos y servicios de negocio degradados, cada uno con enlace a la sección que lo explica. Muestra
All clear.cuando no hay nada en lo que actuar. - Flota por componente — El entorno agrupado en componentes de Fabric, con acceso directo a Fabric Resources
- Servicios de negocio — Estado de los servicios nombrados que ha definido, con acceso directo a la lista completa
- Explorar — Un mosaico de lanzamiento para cada sección de Fabric, de modo que todo el menú sea accesible desde una sola pantalla
Cuando no hay ninguna cuenta de Fabric conectada, la página lo indica y ofrece Connect Fabric account en lugar de mostrar paneles vacíos.
Fabric Accounts
Conecte y gestione los tenants de Microsoft Fabric que Beak supervisa. Cada cuenta ejecuta el ciclo de vida completo — conéctese con las credenciales del service principal, sincronice el inventario, profundice en una vista general y lista de recursos por cuenta, y elimínela cuando ya no sea necesaria. Cada cuenta descubre sus propios espacios de trabajo, capacidades y elementos.
La sincronización se ejecuta cada hora por defecto. En la Opción A cubre todo el tenant; en la Opción B cubre exactamente los espacios de trabajo a los que se añadió el SP, lo que convierte la página de cuenta en el lugar para verificar que la cobertura concedida coincide con la cobertura prevista.
Fabric Resources
Cada elemento de Fabric descubierto en todas las cuentas conectadas, organizado por componente de Fabric en lugar de por categoría de nube genérica. La pestaña All es la vista general agregada; cada pestaña de componente limita los mosaicos, gráficos, recuentos, filtros y la tabla a ese componente. Un filtro de espacio de trabajo en la barra de herramientas es el equivalente en Fabric a un grupo de recursos y se aplica en todas las pestañas.
La taxonomía de componentes es:
- Data Factory y Pipelines — Orquestación y movimiento de datos
- Lakehouse, Data Warehouse y Databases (Fabric SQL DB) — Motores de almacenamiento y consulta
- Data Engineering y Notebooks — Cargas de trabajo de Spark y notebook
- Data Science — Elementos de modelos y experimentos
- Power BI y Semantic Models — Informes y los modelos que los sustentan
- Real-Time Intelligence, Eventstreams y KQL Database — Streaming y análisis en tiempo real
- Mirroring — Elementos de bases de datos reflejadas
- Other — Todo lo que queda fuera de la taxonomía anterior
Monitors
Cada monitor vinculado a una cuenta de Fabric, en una vista con ámbito de Fabric — la página principal de Monitors permanece global en todos los proveedores. Las columnas tienen forma de Fabric (componente, espacio de trabajo, capacidad) en lugar de las genéricas de nube (región, suscripción): estado, monitor, componente, espacio de trabajo, capacidad, intervalo y última comprobación.
La vista está paginada en el servidor con búsqueda, filtro y ordenación por columna, selector de columnas, exportación a CSV / PDF y pausa / reanudación en lote, por lo que se mantiene utilizable con decenas de miles de monitores.
Data Pipelines
La vista del operador "¿está todo bien ahora mismo?" para los pipelines de datos de Fabric. Cada cifra proviene de comprobaciones de monitores, ejecuciones de pipelines y programaciones de elementos — nada en esta página es un marcador de posición.
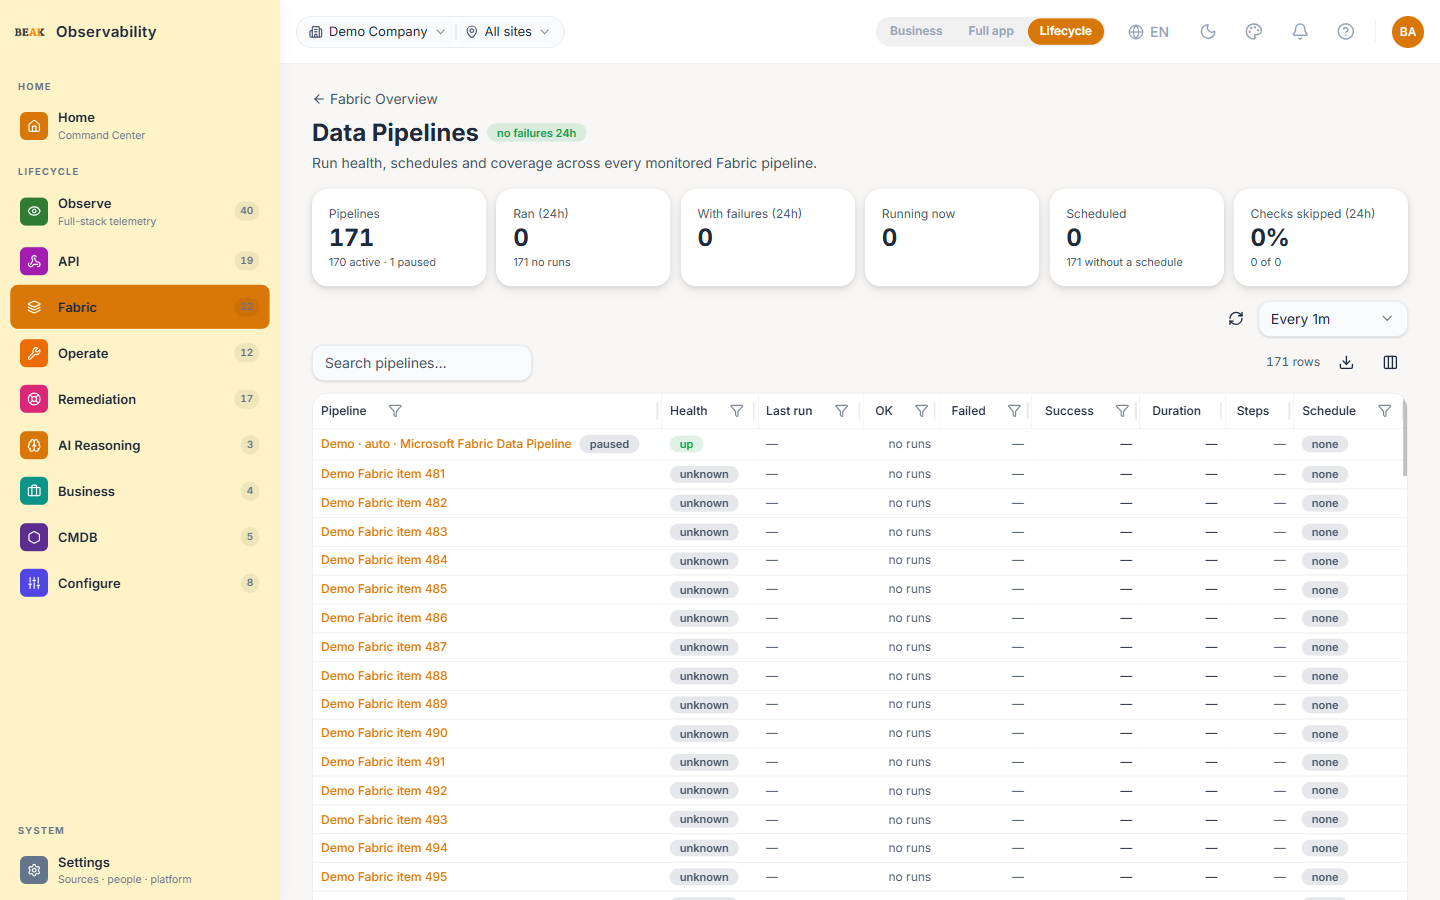
- Pipelines — Total, dividido entre activos / en pausa
- Ejecutados (24h) — Cuántos se ejecutaron y cuántos no tuvieron ninguna ejecución
- Con fallos (24h) — Pipelines con al menos una ejecución fallida
- Ejecutándose ahora — En ejecución actualmente
- Programados — Cuántos tienen una programación y cuántos no tienen ninguna
- Comprobaciones omitidas (24h) — La proporción de comprobaciones que Beak omitió deliberadamente para mantenerse dentro del límite de API por tenant de Fabric
La tabla añade última ejecución, recuentos de correctas y fallidas, tasa de éxito, duración, número de pasos, programación y cadencia, con búsqueda, filtros, ordenación, selector de columnas y exportación.
Tres reglas de presentación son deliberadas, porque lo contrario se publicó como un error en su momento:
- Un pipeline sin ejecuciones muestra
no runs— nunca0%ni un tick verde - Una comprobación limitada se notifica como colección omitida por Beak — nunca como si el pipeline no estuviera disponible
no schedulees una desconocida explícita — no "nada perdido"
Nota: Los intervalos de sondeo se derivan de la cadencia propia de cada pipeline para reducir el gasto en la API de Fabric, por lo que un alto porcentaje de comprobaciones omitidas es un vacío de recopilación en el lado de Beak, no una interrupción de la flota. La página lo indica en línea siempre que supere la cuarta parte de las comprobaciones.
Business Services
Cadenas de dependencia nombradas de elementos de Fabric, supervisadas como una unidad — agrupe el pipeline, notebook, dataflow, lakehouse, almacén y modelo semántico que hay detrás de "Monthly Payroll" y supervise el resultado en lugar de seis filas no relacionadas.
- Crear un servicio — Asígnele un nombre y seleccione miembros por tipo de elemento
- Suggest — Beak propone servicios candidatos agrupados por linaje cuando está disponible, de lo contrario por espacio de trabajo; revise y añada individualmente o todos a la vez
- Consolidación de estado — Cada servicio informa
Healthy,Degraded,DownoUnknown, con un desglose de miembros total / fallidos / degradados
Data Freshness
El grado de obsolescencia de cada modelo semántico y si su última actualización falló. Los datasets se clasifican en Fresh, Stale, Failing o Unknown, con la hora de la última actualización, el último estado y los recuentos resumidos por banda. Los modelos que nunca se han actualizado se etiquetan como tal en lugar de contarse como frescos.
Data SLA
Cumplimiento de la tasa de éxito en 24 horas para cargas de trabajo de Fabric programadas — pipelines, notebooks, trabajos de Spark, dataflows y modelos semánticos. Cada carga de trabajo muestra su tipo, cumplimiento en 24 horas, banda (Met, At risk, Breached, Unknown) y objetivo.
Los objetivos son editables por carga de trabajo y anulan el valor predeterminado del tenant; el evaluador de fiabilidad genera un incidente cuando una carga de trabajo cae por debajo de su objetivo. Borrar un objetivo vuelve al valor predeterminado del tenant.
Capacity Intelligence
Tendencia de utilización, previsión de agotamiento y recomendación de escalado por capacidad — utilización actual, tendencia, pico previsto, tiempo hasta el throttling y eventos de throttling en las últimas 24 horas, con una recomendación como Scale F16 → F32 o hold.
Nota: La utilización, la tendencia y las recomendaciones necesitan métricas de unidades de capacidad de la aplicación Fabric Capacity Metrics o métricas de CPU de Azure Monitor en la capacidad. Sin ninguna de las dos concesiones solo se recopila el estado del ciclo de vida, y la página lo indica — las columnas se completan automáticamente una vez concedido el acceso, sin necesidad de volver a desplegar.
Ops Center
Un panel agregado de todo el entorno: servicios caídos y degradados del total, SLA incumplido y en riesgo, datasets fallidos y obsoletos, y capacidades en riesgo del total. Es la única pantalla que debe mantenerse abierta durante un incidente en la plataforma de datos.
Lineage Health
El grafo de linaje del flujo de datos — aristas feeds y powers — a través de sus servicios de negocio, para que pueda ver qué informe pierde datos cuando falla un pipeline ascendente. Necesita linaje de la API Scanner (administrador) más servicios de negocio con elementos miembros; hasta que ambos existan la página lo indica exactamente en lugar de mostrar un lienzo vacío.
AI Root Cause
Seleccione un elemento con fallos y Beak rastrea su cadena causal, basándose primero en evidencias, desde el linaje y el estado reales en lugar de una plantilla genérica. La pantalla lista lo que está fallando ahora, luego para el elemento seleccionado muestra la cadena causal, la causa raíz probable y sus dependencias ascendentes. Cuando nada incumple su SLA, lo indica.
Ops Copilot
Consulte sobre el entorno de Fabric y obtenga respuestas calculadas a partir de datos de supervisión en tiempo real, no del recuerdo de un modelo. Las preguntas guiadas cubren las cuatro preguntas que realmente hacen los operadores:
- ¿Qué datasets están obsoletos o fallando?
- ¿Qué está incumpliendo su SLA?
- ¿Qué capacidades están bajo presión?
- ¿Qué servicios de negocio no son saludables?
Cada respuesta se resuelve con datos actuales, incluyendo el caso negativo (All datasets are fresh.). Las consultas en lenguaje natural de forma libre son una mejora planificada.
Knowledge Graph
Servicios de negocio y sus elementos miembros en todo el entorno, como un grafo interactivo con raíz en Fabric estate. Haga clic en un nodo para ver sus propiedades y use los chips para profundizar en una rama. El grafo se completa a medida que se sincroniza la topología y se definen los servicios de negocio; el linaje del tenant completo también necesita la API Scanner.
Workspace Governance
Higiene de gobernanza en sus espacios de trabajo de Fabric, puntuada sobre 100 con los hallazgos que determinaron la puntuación:
- Sin capacidad asignada — Espacios de trabajo sin asignación de capacidad
- Espacios de trabajo vacíos — Aprovisionados pero sin contenido
- Espacios de trabajo inactivos — Abandonados o detenidos
La tabla clasifica los espacios de trabajo por riesgo (High, Medium, Low, OK) con hallazgos, recuento de elementos, capacidad y estado. Esta superficie funciona únicamente con las concesiones obligatorias; las señales de propietario y permisos necesitan la API Scanner.
Change Intelligence
Quién cambió, ejecutó y vio qué en todo el entorno, a partir de eventos de actividad de administrador. Las operaciones de cambio — crear, actualizar, eliminar, desplegar, renombrar — se distinguen del ruido de ejecuciones y vistas, de modo que la pregunta "¿qué cambió justo antes de que esto fallara?" tiene una sola respuesta.
- Cambios — Operaciones de cambio en la ventana
- Actividad total — Todos los eventos de actividad
- Usuarios activos — Usuarios distintos
- Espacios de trabajo afectados — Espacios de trabajo distintos
La tabla de eventos contiene cuándo, operación, elemento, usuario y espacio de trabajo. Necesita eventos de actividad de administrador (Tenant.Read.All más la configuración de APIs de administrador de solo lectura).
Semantic Model Intelligence
Fiabilidad de actualización y actualidad para cada modelo semántico, con cumplimiento en 24 horas y el motivo del último fallo. El estado de las filas se consolida a partir de comprobaciones de actualización en caché, por lo que abrir la página no realiza ninguna llamada a Microsoft.
- Modelos semánticos — Total descubierto
- Fresh / Attention / Stale — Clasificación de actualidad en toda la flota
- Fallos de actualización (24h) — Total de actualizaciones fallidas
La tabla lista el modelo, la última actualización, la banda de actualidad, los recuentos de correctas / fallidas en 24 horas, el cumplimiento del SLA y el motivo del último fallo. Cuando la telemetría de actualización cubre menos de la mitad de los modelos descubiertos, la página indica la fracción cubierta y la concesión que la amplía, en lugar de notificar el resto como saludable. El tamaño del dataset por modelo, la huella de memoria y la tendencia de duración de la actualización necesitan acceso a DMV / XMLA y se señalan como pendientes.
Query Performance
Estado del motor en los endpoints SQL de Fabric, bases de datos KQL y capacidades — duración media de las consultas, solicitudes activas y en cola, y consultas fallidas en la última hora, más una tabla por endpoint con el snapshot de mayor duración. Se lee a partir de comprobaciones de sondeo en caché, sin llamadas a Microsoft al cargar la página.
Cuando no se ha reportado telemetría de consultas, la página lo indica y nombra las tres fuentes que la proporcionan: el sondeo SQL DMV, las estadísticas de consultas KQL y la aplicación Capacity Metrics. El texto y la duración por consulta necesitan una recopilación por consulta y se señalan como una mejora posterior.
Notebook Observability
Fiabilidad de ejecución por notebook, a partir de comprobaciones de ejecución en caché — cumplimiento, recuentos de correctas y fallidas en 24 horas, y el motivo del último fallo, junto al total de notebooks del resumen de recursos. El detalle de etapas de Spark, el uso de ejecutores y los trazos por ejecución necesitan supervisión de Spark / Livy y se señalan como una mejora posterior.
Superficies con acceso restringido
Tres pantallas están construidas y conectadas, pero con acceso restringido a datos: necesitan una concesión de Microsoft que la mayoría de los tenants no han realizado el primer día. En lugar de mostrar números inventados, cada una indica qué concesión la desbloquea y exactamente qué mostrará. Se activan automáticamente una vez que la concesión está en vigor y los sondeos comienzan a escribir comprobaciones — sin necesidad de volver a desplegar.
- AI Capacity Optimization — Capacidades inactivas o infrautilizadas con un SKU objetivo, elementos zombie que consumen capacidad pero no tienen ejecuciones ni vistas, programaciones de actualización ineficientes y un ahorro mensual estimado. Necesita la aplicación Capacity Metrics (CU por elemento).
- AI Cost Optimization — Coste de capacidad asignado a elementos según su proporción del consumo de CU, consolidado por espacio de trabajo, propietario y departamento para devolución de costes o visibilidad, con los principales impulsores de costes y la tendencia mes a mes. Necesita la aplicación Capacity Metrics (asignación de CU por elemento).
- Power BI Experience Monitoring — Tiempos de carga del panel y renderizado por visual, los visuales más lentos, tiempo de ejecución de DAX, usuarios concurrentes y fallos por navegador y geografía. Necesita Workspace Monitoring, habilitado por espacio de trabajo por el cliente.
Mapa de acceso y capacidades
Qué capacidad necesita qué concesión. Todo lo del nivel obligatorio funciona en cualquier tenant conectado; el resto tiene acceso restringido a datos y se completa automáticamente cuando la concesión está en vigor.
- Solo concesiones obligatorias — Inventario, jerarquía, estado de la flota, Workspace Governance, alertas, servicios de negocio, Data Freshness, Data SLA y alertas de estado de ejecución
- Eventos de actividad de administrador — Change Intelligence
- Aplicación Capacity Metrics, o Azure Monitor
Monitoring Reader— Utilización y previsión de Capacity Intelligence, AI Capacity Optimization, AI Cost Optimization - Linaje de la API Scanner (administrador) — Lineage Health por salto, cadenas causales de AI Root Cause, sugerencias de servicios de negocio basadas en linaje
Vieweren el espacio de trabajo más DMV / XMLA — Profundidad de Semantic Model Intelligence, Query Performance Observatory- Supervisión de Spark / Livy — Detalle de Spark en Notebook Observability
- Workspace Monitoring — Power BI Experience Monitoring
Para desbloquear la mayor capacidad con el menor esfuerzo, conceda en este orden: primero la aplicación Capacity Metrics (desbloquea utilización, previsión, optimización de capacidad y devolución de costes en un solo paso), luego las APIs de administrador de solo lectura más un análisis de administrador completado para linaje real y profundidad de RCA, luego Viewer en el espacio de trabajo en los espacios de trabajo que le interesan.
Buenas prácticas
- Comience con la Opción B. El acceso
Viewercon ámbito de espacio de trabajo es la solicitud menor, le proporciona todo el inventario y el historial de ejecuciones, y puede ampliar a todo el tenant más adelante sin reconectar. - Verifique la cobertura tras la primera sincronización. En la Opción B, compare la lista de espacios de trabajo descubiertos con los espacios de trabajo que pretendía conceder — cualquier espacio omitido es invisible en lugar de reportarse como saludable.
- Defina los servicios de negocio desde el principio. Casi cada consolidación, cadena de RCA y respuesta del copilot se vuelve más precisa una vez que Beak sabe qué elementos pertenecen al mismo resultado. Use
Suggestpara el primer pase. - Establezca objetivos de SLA por carga de trabajo, no de forma global. Un pipeline de informes nocturno y un pipeline de ingesta por hora no deben compartir un mismo objetivo de cumplimiento.
- Interprete el mosaico de comprobaciones omitidas como gasto, no como fallo. Refleja que Beak se mantiene dentro del límite de API de Fabric; si necesita una cobertura más estrecha, eso es una conversación sobre el intervalo de sondeo.
- Trate las pantallas con acceso restringido como una lista de verificación de incorporación. Cada una nombra la concesión que la activa, y ninguna necesita un redespliegue posterior.
Páginas relacionadas
- Cloud — el motor compartido de cuenta, sincronización y desglose de recursos que reutiliza Fabric Accounts
- Monitors — la flota global de monitores en todos los proveedores
- Alerts — donde los fallos de ejecución y actualización de Fabric aparecen como alertas
- Knowledge Graph — el grafo multicapa que alimenta la topología de Fabric
- Logs — donde los eventos de actividad de Fabric se almacenan como registros en los que se puede buscar