Dashboard
El Dashboard es la página de inicio de Beak Observability. La página se encuentra bajo el encabezado OBSERVE · OVERVIEW y es un resumen en una sola pantalla del estado de los monitores, la flota de hosts, los incidentes activos, la inteligencia de Kubernetes, las integraciones en la nube y las recomendaciones de costos de FinOps. Se actualiza cada quince segundos para que los equipos de guardia puedan mantenerla abierta durante una ventana de triaje.
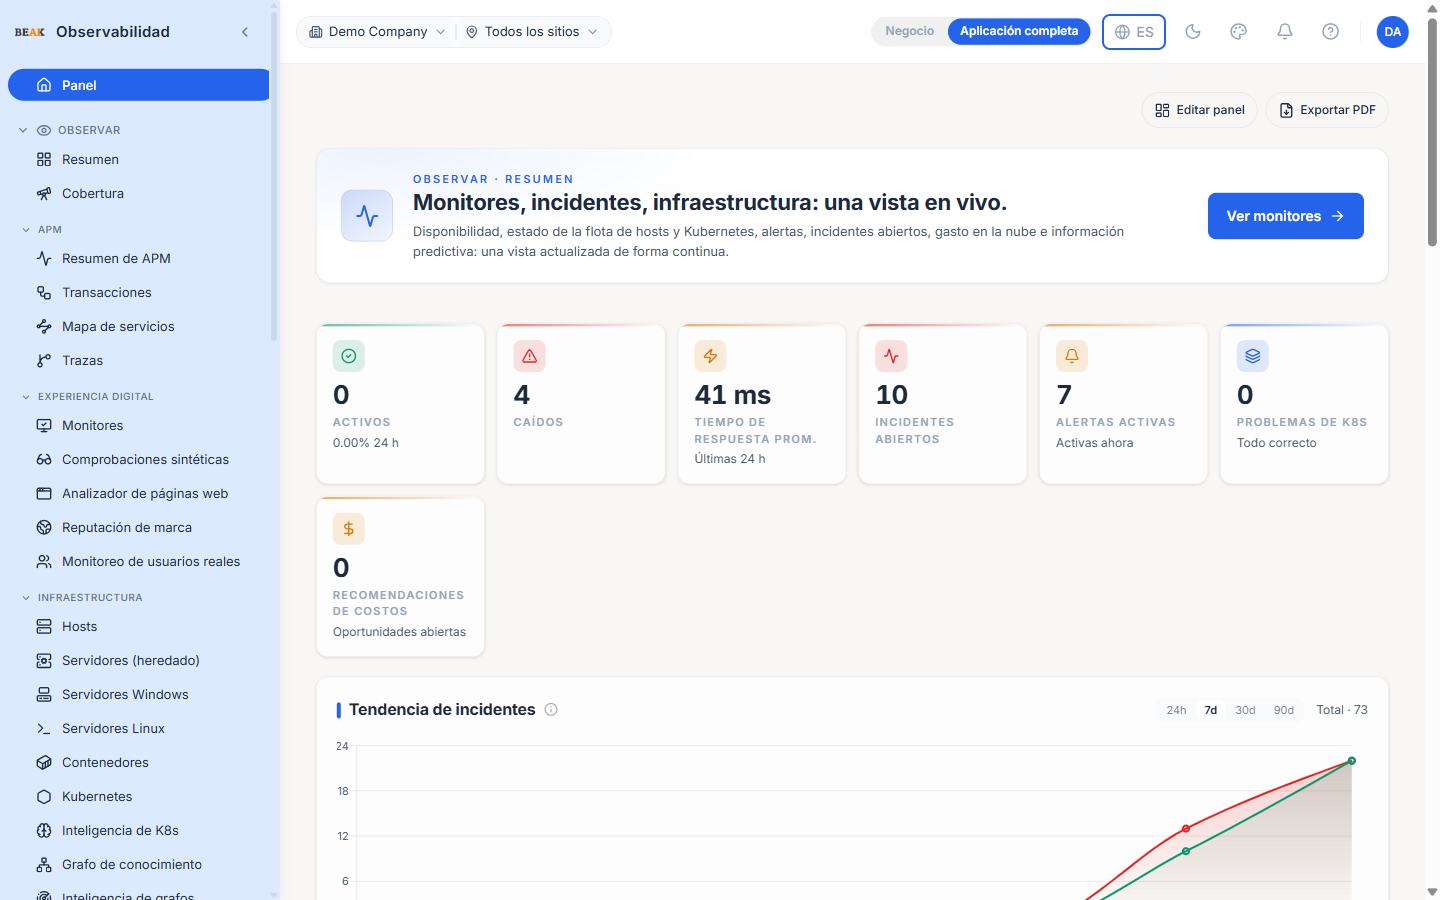
El encabezado de la página resume la sección como "Monitores, incidentes, infraestructura — una vista en vivo. Tiempo de actividad, flota de hosts y salud de Kubernetes, alertas, incidentes abiertos, gasto en la nube e información predictiva — una vista continuamente actualizada."
Franja Principal
La franja principal en la parte superior de la página resume el tenant de un vistazo. Cada mosaico es clicable y enlaza directamente a la página subyacente con el filtro correspondiente aplicado previamente.
- UP — Cantidad de monitores sintéticos que actualmente están pasando
- DOWN — Cantidad de monitores sintéticos que actualmente están fallando
- AVG RESPONSE — Tiempo de respuesta HTTP promedio de las últimas veinticuatro horas
- OPEN INCIDENTS — Casos activos en el motor de reglas más incidentes ingestados de sistemas ITSM conectados
- ACTIVE ALERTS — Alertas que se están disparando actualmente en el motor de reglas y fuentes ingestadas
- K8S ISSUES — Recuento total de problemas entre incidentes abiertos, alertas de terceros activas, pods reiniciándose y nodos no disponibles; muestra "No clusters registered" antes de que se agregue algún clúster
- COST RECOMMENDATIONS — Recomendaciones de FinOps abiertas; muestra "Not configured" antes de que la integración de FinOps esté configurada
Una acción View monitors se encuentra junto a la franja para navegar con un solo clic hacia la lista completa de monitores.
Tendencia de Incidentes
El gráfico de tendencia de incidentes muestra cuántos incidentes se iniciaron y resolvieron durante la ventana seleccionada. Cambie el rango de tiempo con los botones 24h / 7d / 30d / 90d.
Incidentes Activos
Un feed consolidado que combina monitores sintéticos que han pasado al estado down e incidentes del motor de reglas en estado open. Se muestran las primeras ocho filas — al hacer clic en cualquier fila se abre el monitor correspondiente o se accede a la página de Incidentes. Un enlace View all se encuentra junto al encabezado de la sección.
Principales Problemas de K8s
Extraídos del servicio de Inteligencia K8s. La lista combina cuatro tipos de problemas:
- Open incidents — Incidentes del motor de reglas con alcance a objetivos de Kubernetes
- Node pressure — Nodos marcados como
NotReady - Ingested alerts — Alertas de terceros abiertas (Datadog / Splunk / etc.) etiquetadas a un objetivo de Kubernetes
- At-risk pods — Pods que se reinician más del umbral configurado en la última hora
El encabezado de la sección incluye una acción Open intelligence que accede a K8s Intelligence. Al hacer clic en cualquier fila se navega con el objetivo preseleccionado.
Integraciones en la Nube
Un panel de Cloud integrations resume cada cuenta de nube conectada. La acción Manage abre la página de Cloud para agregar o editar integraciones.
Principales Fuentes de Alertas Ruidosas
El panel de fuentes de alertas más ruidosas clasifica las fuentes que contribuyen mayor volumen en la ventana. Úselo para identificar reglas que necesitan ajuste. La acción View alerts accede al feed completo de Alertas. Los datos provienen del servicio de agregación de K8s Intelligence.
Infraestructura
El resumen de infraestructura en la parte inferior del dashboard resume la flota de hosts:
- TOTAL — Total de hosts registrados
- ONLINE — Hosts que han reportado en los últimos 120 segundos
- OFFLINE — Hosts que no han reportado dentro de la ventana
- AVG CPU — Utilización media de CPU en los hosts en línea
- AVG MEM — Utilización media de memoria en los hosts en línea
La acción View all hosts accede a la página de Hosts.
Inteligencia Predictiva
Cuatro paneles compactos y clicables muestran las señales prospectivas de la plataforma para que los equipos de guardia puedan actuar antes de que algo falle. Cada panel resume los elementos principales y enlaza a su página completa:
- Predicted Failures — Entidades con mayor probabilidad de fallar pronto, clasificadas por una puntuación de riesgo del 0 al 100. Abre Predictions & Intelligence.
- Anomaly & RCA — Monitores cuyo comportamiento reciente se desvía más de su línea base, clasificados por severidad. Abre la página de Anomaly & RCA.
- Predicted Breaches — Monitores con pronóstico de incumplir su objetivo de SLA, mostrando el tiempo hasta el agotamiento o una marca
Breached. Abre la página de SLA. - Top Unhealthy Monitors — Monitores actualmente en estado
down,warn,probe_erroroconfig_error, para que los peores casos estén a simple vista. Abre la lista de Monitores.
Cada panel se actualiza con su propia cadencia y solo consulta datos mientras está visible. Al igual que los demás paneles del dashboard, cada uno puede reordenarse u ocultarse con el control Edit dashboard.
Nota: Estos paneles reemplazan la antigua tabla "Top monitors", que solo duplicaba la lista de monitores a un clic de distancia. Los mosaicos principales Up / Down siguen enlazando directamente a la página completa de Monitores.
Mejores Prácticas
- Mantenga el Dashboard abierto en un monitor de pared durante la respuesta a incidentes — la cadencia de actualización de 15 segundos lo convierte en un tablero de operaciones en vivo.
- Si el mosaico de K8s muestra cero pero el equipo sabe que un clúster está en mal estado, verifique que el clúster esté registrado en Kubernetes y que el recolector de Kubernetes Intelligence esté configurado.
- El mosaico de FinOps solo se muestra cuando la integración de FinOps está habilitada — consulte FinOps para la configuración.
- La navegación por clic es más rápida que la barra lateral para el triaje — cada mosaico y fila es un punto de acceso.
Páginas Relacionadas
- Monitors — Inventario de monitores sintéticos y flujos de edición
- Hosts — Flota de hosts de infraestructura
- Incidents — Feed unificado de incidentes (motor de reglas + ingestados)
- Predictions & Intelligence — Fallos previstos, anomalías, pronósticos y ETAs de incumplimiento de SLA
- K8s Intelligence — Problemas de Kubernetes pasados, actuales y previstos
- FinOps — Recomendaciones de costos y anomalías
- Beak Observability Overview — Descripción general del producto