Mapa del Clúster
La página Cluster Map (etiqueta de navegación Health Map, /kubernetes/map, dentro del grupo Infrastructure) es un mapa de salud en lenguaje natural de un único clúster — muestra de un vistazo dónde se encuentra un problema y qué afecta, sin necesidad de leer objetos de Kubernetes sin procesar. Combina un resumen escrito de "necesita atención" con un grafo de topología interactivo.
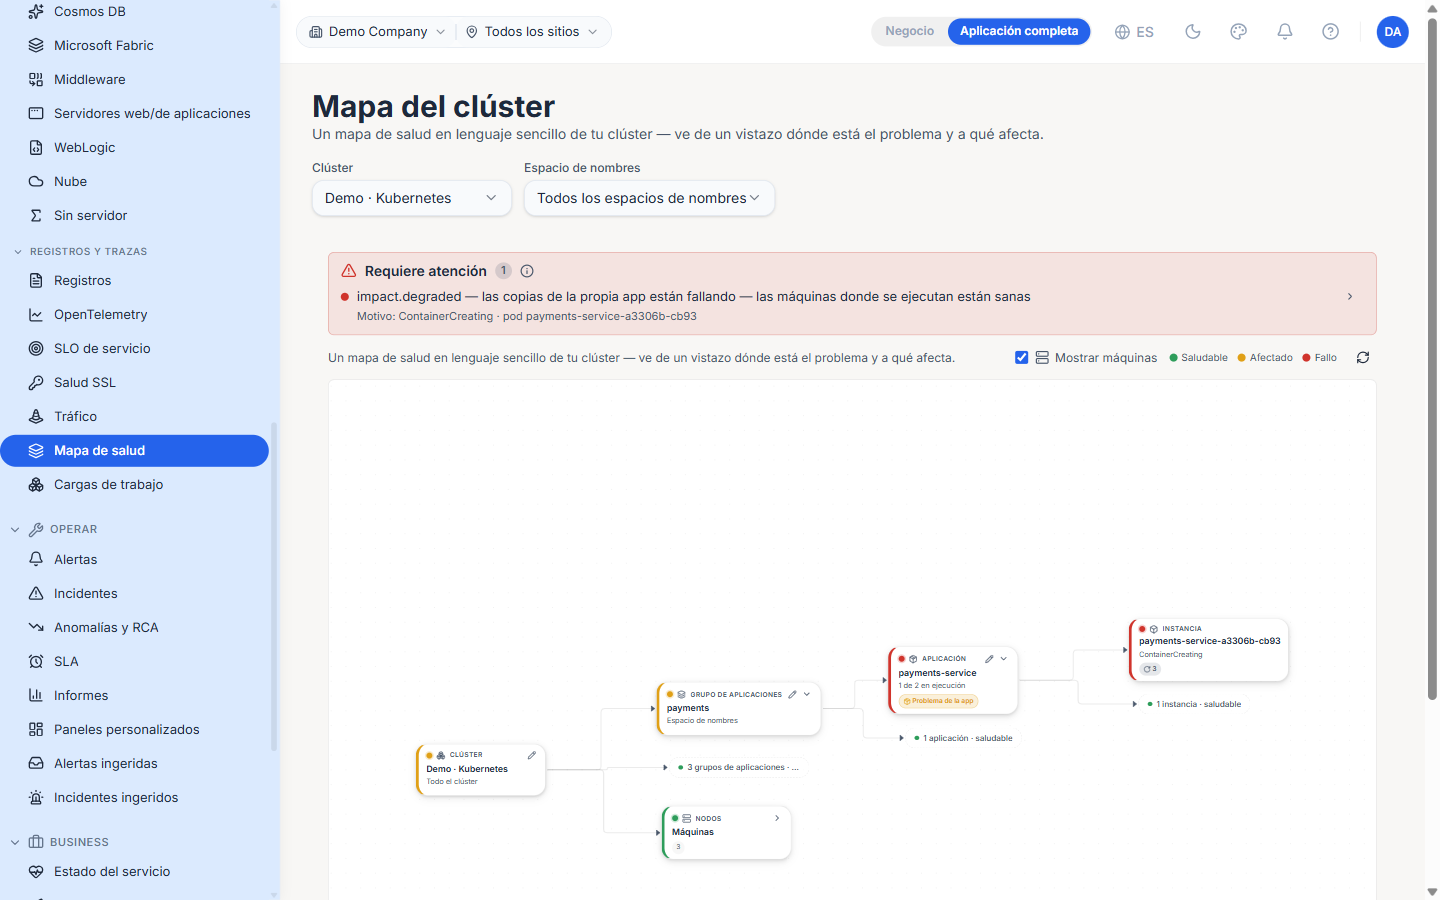
Selectores de clúster y espacio de nombres
Dos selectores en la parte superior delimitan el mapa: Cluster selecciona un clúster registrado, y Namespace lo reduce a un único espacio de nombres o a All namespaces.
Necesita atención
Un panel destacado enumera los problemas actuales en lenguaje natural en lugar de códigos de estado — por ejemplo, impact.degraded — the app's own copies are failing — the machines they run on are healthy, con una línea Why: que nombra la causa subyacente (p. ej. ContainerCreating · pod payments-service-…). El contador en el encabezado del panel indica cuántos problemas están abiertos, y cada entrada se expande hasta el objeto afectado.
El mapa
Debajo del panel se encuentra un grafo interactivo. El interruptor Show machines añade los nodos subyacentes, y una leyenda marca cada objeto como Healthy, Affected o Fault. El grafo permite profundizar en la estructura del clúster:
- Cluster — El clúster completo, con su estado de salud consolidado.
- App group — Un espacio de nombres, mostrado como un grupo de aplicaciones.
- Application — Una carga de trabajo, con su conteo de réplicas en ejecución y una insignia de "problema de aplicación" cuando está deteriorada.
- Instance — Un pod individual, con su fase (p. ej.
ContainerCreating). - Nodes — Las máquinas en las que se ejecutan las cargas de trabajo, de modo que se pueda distinguir un fallo de aplicación de un fallo de máquina.
Seguir la cadena desde una aplicación en rojo hasta una máquina en buen estado es lo que hace que la historia de "las copias de la aplicación están fallando, las máquinas están bien" sea obvia de un vistazo.
Mejores prácticas
- Lea primero el panel Needs attention y luego use el mapa para confirmar el radio de impacto — el panel le indica qué, el grafo le indica hasta dónde.
- Active Show machines cuando una aplicación parezca poco saludable pero no se pueda determinar el motivo; un fallo en un nodo compartido suele explicar varias aplicaciones afectadas a la vez.
- Acote el selector Namespace en un clúster con mucha actividad — la vista de todos los espacios de nombres es completa pero densa cuando ya se sabe qué equipo está afectado.
Páginas relacionadas
- Kubernetes — Registro de clústeres y pestañas de recursos por clúster
- Workloads — La tabla de salud clasificada y entre clústeres
- K8s Intelligence — Problemas de Kubernetes actuales, pasados y predichos