Descripción General de Fuentes de Datos
Las fuentes de datos exponen conocimiento, datos estructurados e información de aplicaciones SaaS a los agentes a través de una única interfaz de recuperación. Se registran una sola vez, se adjuntan a cualquier número de agentes y se gestionan de forma centralizada con el mismo ciclo de vida de publicación / activación que los agentes y las habilidades.
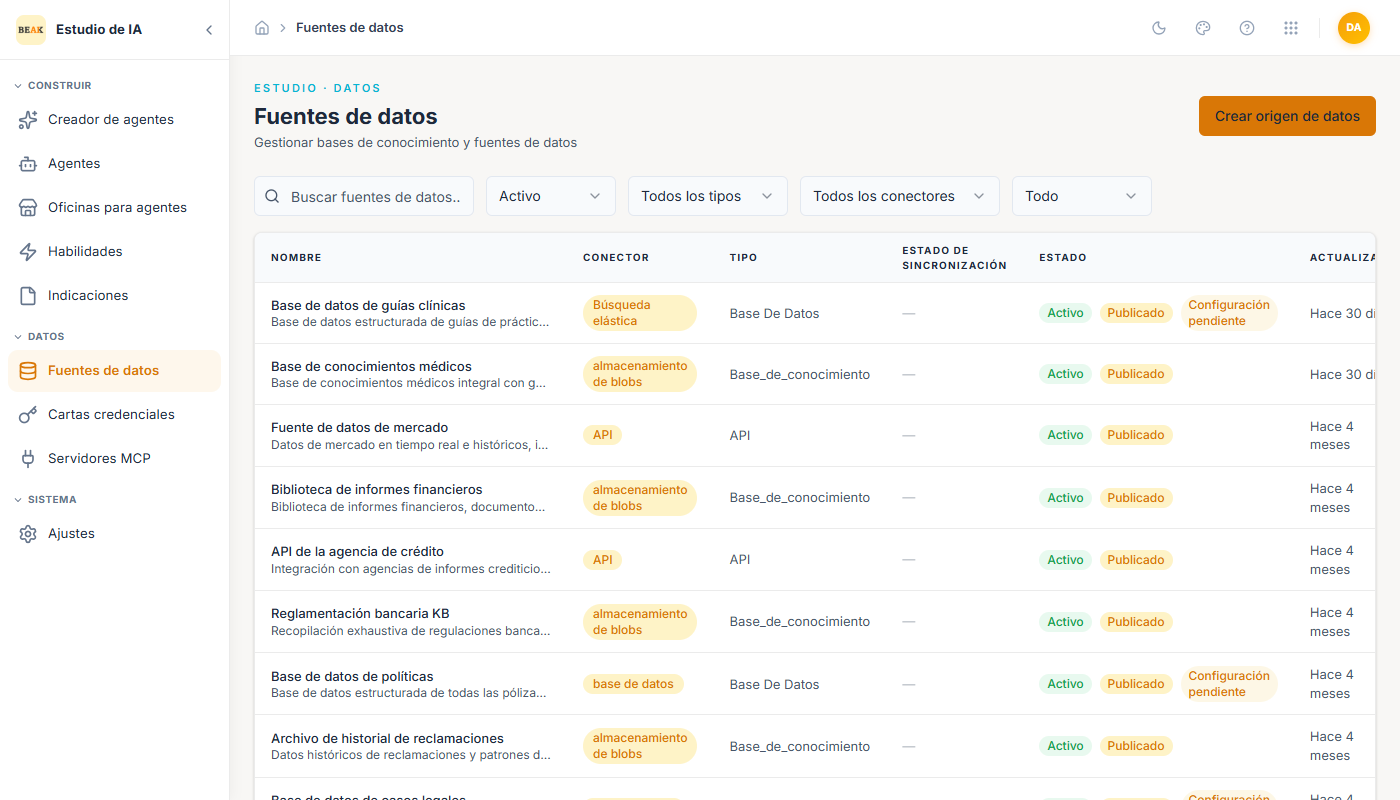
La vista de lista agrupa las fuentes de datos por Connector (p. ej. blob_storage, database, api) y Type (Knowledge_base, Database, Api). Los filtros permiten acotar por estado, tipo y conector. Las fuentes de datos pendientes de configuración muestran el chip Pending Setup.
Crear una Fuente de Datos
Haga clic en Create Datasource en la esquina superior derecha.
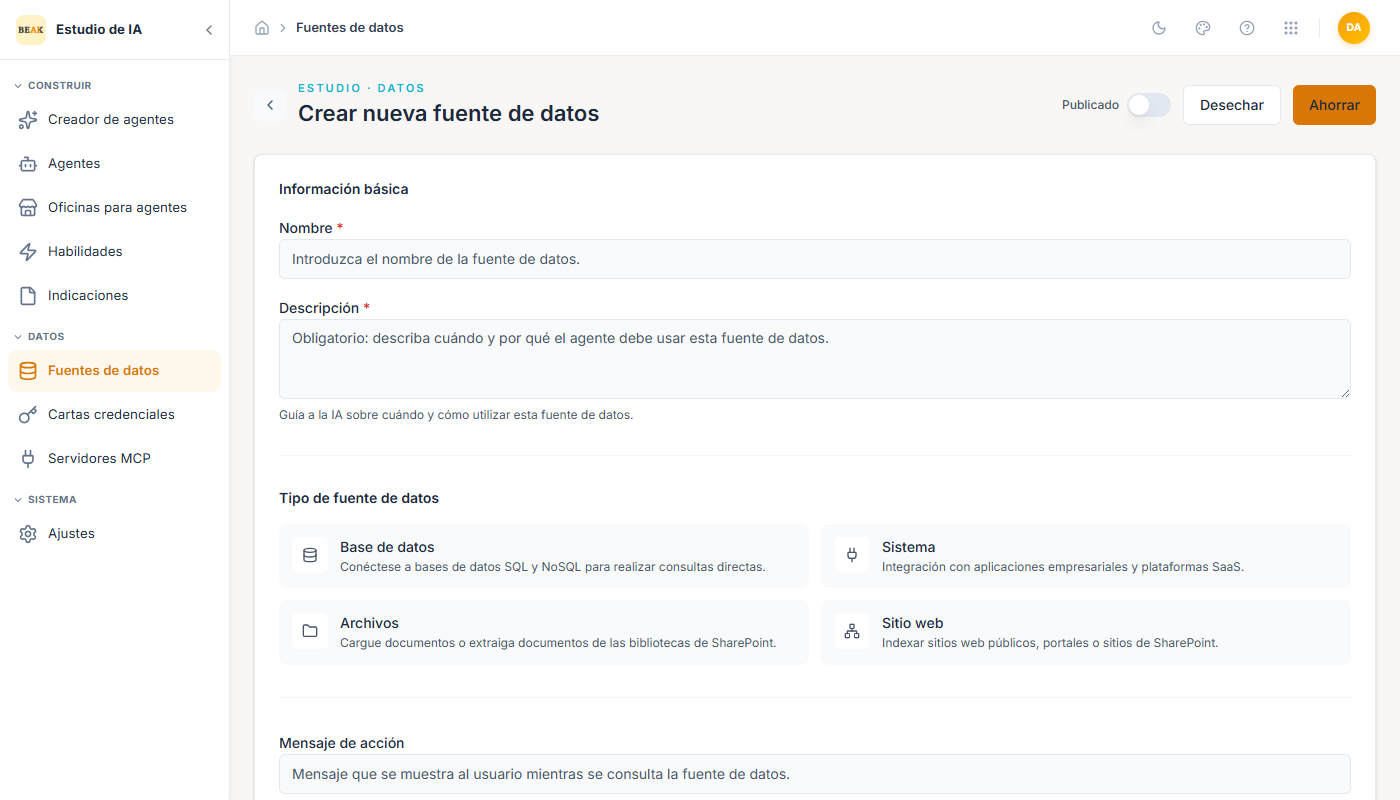
Toda fuente de datos comparte el mismo bloque de metadatos antes de seleccionar un tipo:
- Name — Nombre para mostrar en agentes y listas.
- Description — Se convierte en la instrucción visible para el agente. Indica al LLM cuándo consultar esta fuente de datos.
- Action Message — Cadena de estado opcional que se muestra en el chat mientras se consulta la fuente de datos.
A continuación, seleccione uno de los cuatro tipos. Cada tipo carga su propia cuadrícula Select connector y su formulario de Configuration.
Base de Datos
Conexiones directas a almacenes SQL y NoSQL. Conectores compatibles:
PostgreSQL · MySQL · SQL Server · MongoDB · Redis · Cassandra · Elasticsearch · OpenSearch · Oracle · Azure Log Analytics
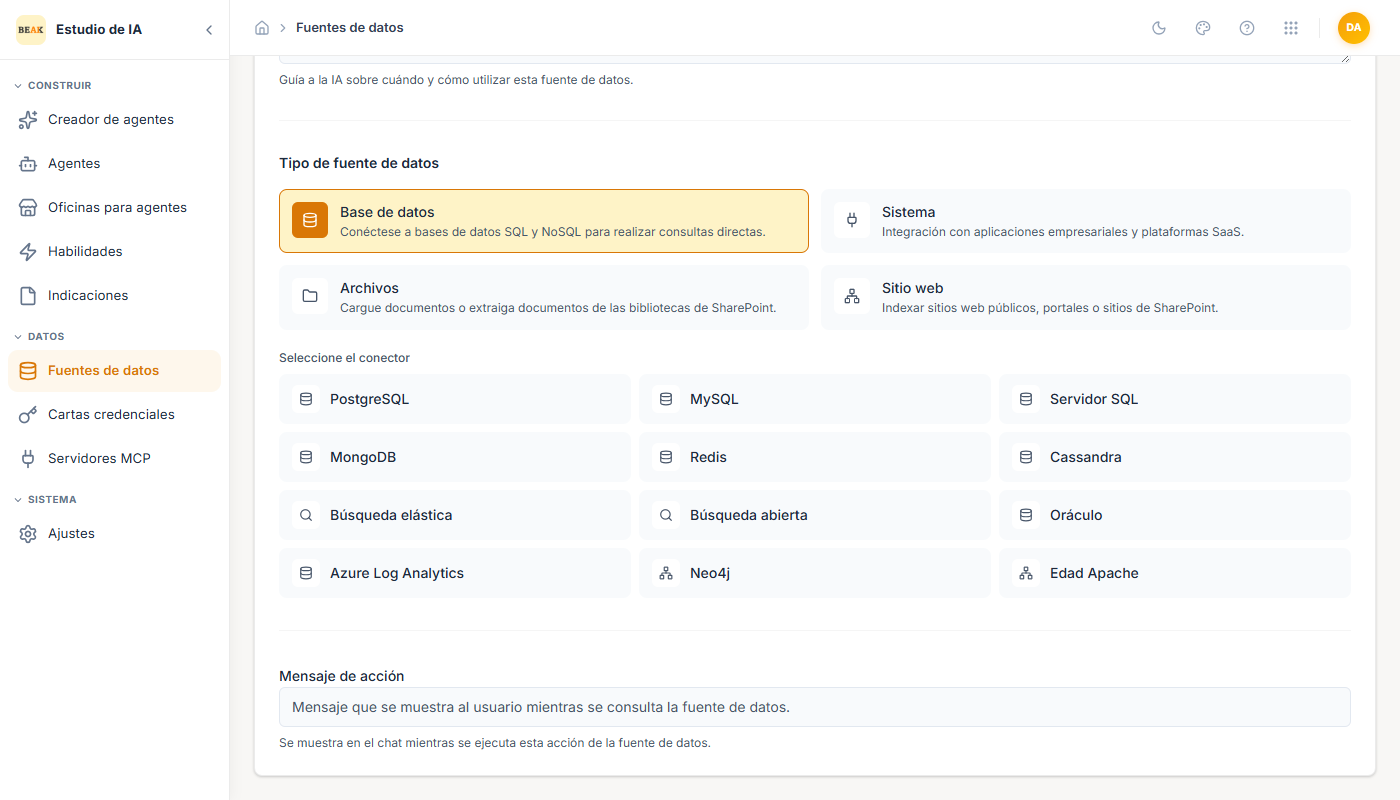
Cada conector expone los campos de conexión que necesita (Host, Port, Database Name, etc.). Tras guardar la conexión, regrese a la fuente de datos para configurar el esquema de base de conocimientos y el planificador que rigen la indexación y la cadencia de actualización.
Sistema
Conectores preconstruidos para aplicaciones empresariales y plataformas SaaS:
ServiceNow · Zendesk · ConnectWise Manage · SentinelOne · Azure DevOps · Microsoft Intune · N-Central · Beak RMM · Atlassian Jira · ManageEngine Endpoint Central · ManageEngine ServiceDesk Plus · Microsoft 365 · Microsoft Entra · Beak ITSM · NinjaOne · Plumsail · SolarWinds Service Desk · Zoho Desk
Cada conector de sistema solicita un Connector Name y el endpoint específico del sistema (p. ej. ServiceNow Instance URL). La autenticación se vincula desde una Credencial en el momento de la asociación.
Archivos
Hay dos fuentes de archivos disponibles:
- Upload Documents — Carga directa de archivos una vez que la fuente de datos ha sido guardada. Los formatos compatibles incluyen PDF, DOCX, XLSX, TXT, MD, HTML y tipos de imagen comunes.
- SharePoint Documents — Indexa una biblioteca de documentos de SharePoint mediante URL.
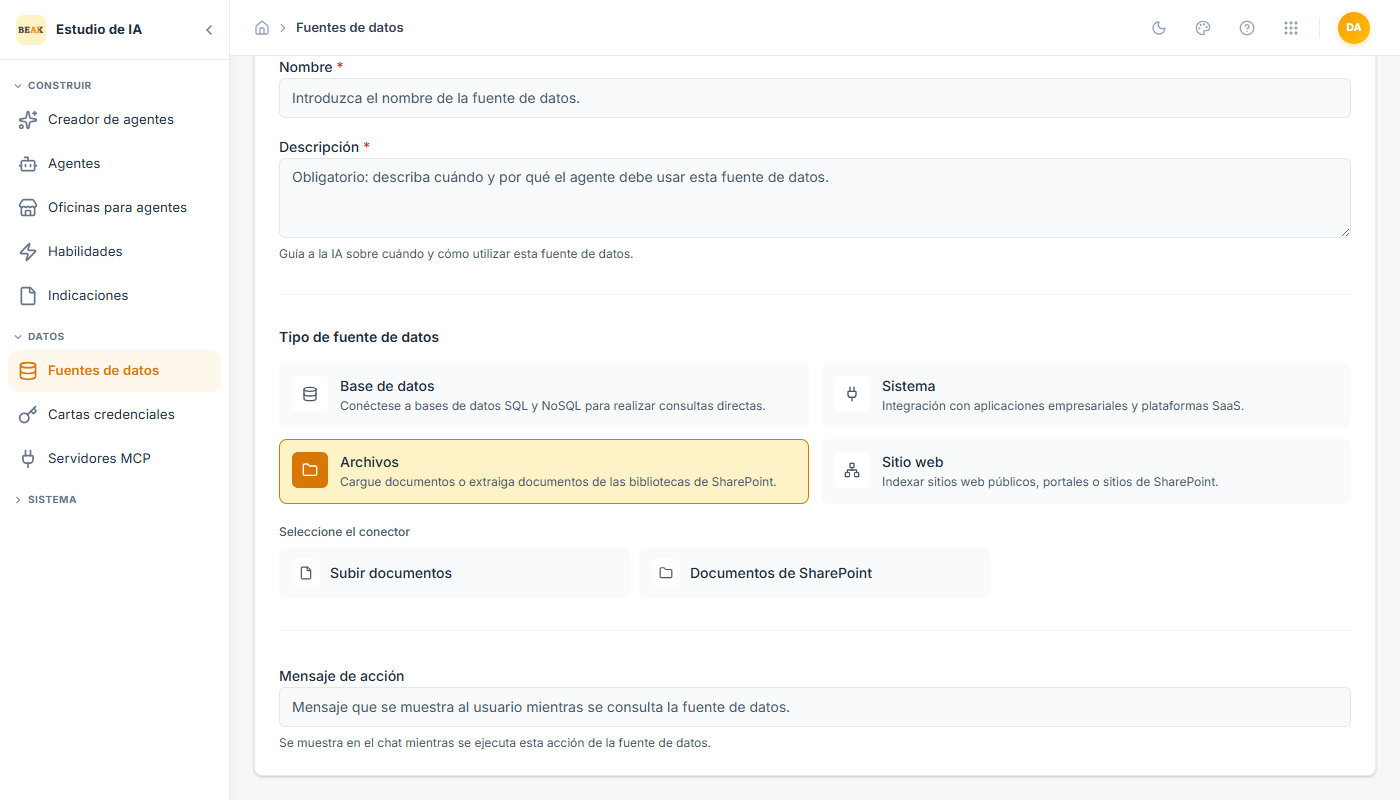
Nota: Para
Upload Documents, guarde primero la fuente de datos. La interfaz de carga aparece en el mismo formulario una vez que se ha creado un borrador.
Sitio Web
Hay tres fuentes de sitio web disponibles:
- Public Website — Una URL accesible que se rastrea e indexa.
- Web Portal — Portal autenticado indexado mediante una credencial almacenada.
- SharePoint Sites — Sitio completo de SharePoint (no solo una biblioteca de documentos).
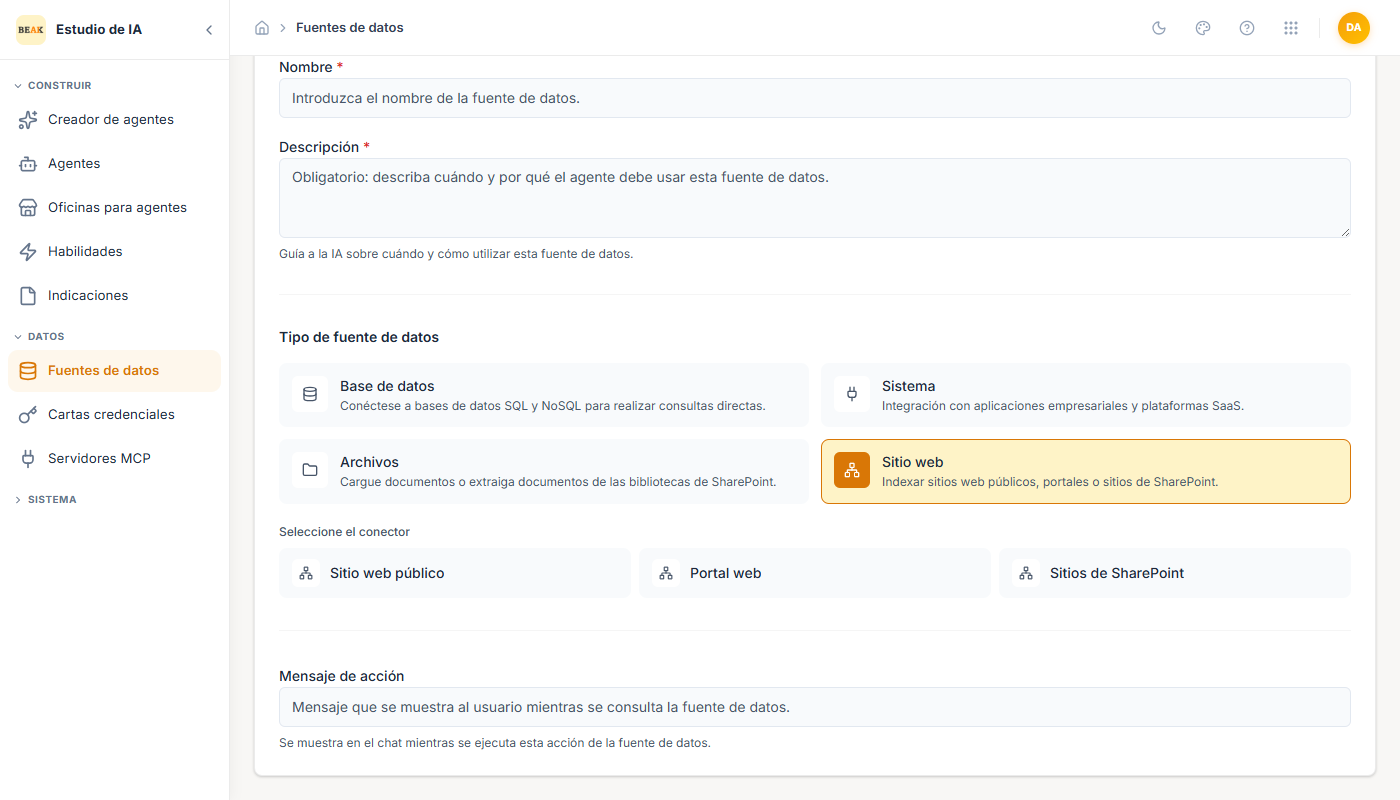
Los sitios web públicos solo requieren una Website URL y una Description opcional. Los portales web y los sitios de SharePoint se vinculan a una credencial para el acceso autenticado.
Ciclo de Vida
Las fuentes de datos siguen el mismo patrón borrador → publicado → activo → inactivo que los agentes y las habilidades. La barra de herramientas expone los controles Save, Published, History y Discard. El chip Pending Setup identifica las fuentes de datos que fueron guardadas pero nunca completaron su paso de esquema/planificador — los agentes no pueden seleccionarlas hasta que estén finalizadas.
Buenas Prácticas
- Defina una Description sólida en cada fuente de datos. El LLM la utiliza como señal de enrutamiento entre fuentes de conocimiento en competencia.
- Para bases de datos, defina un esquema acotado (solo las tablas y columnas que el agente debe ver). Los esquemas amplios confunden al LLM.
- Configure una programación de actualización que se ajuste a la volatilidad de los datos subyacentes — diaria para runbooks, horaria para ticketing, en tiempo real para APIs en vivo.
- Mantenga las bases de conocimiento basadas en archivos bajo un único tema lógico por fuente de datos (p. ej. una para políticas de RRHH, otra para runbooks de ingeniería). Los corpus mixtos reducen la precisión de recuperación.