Evaluaciones
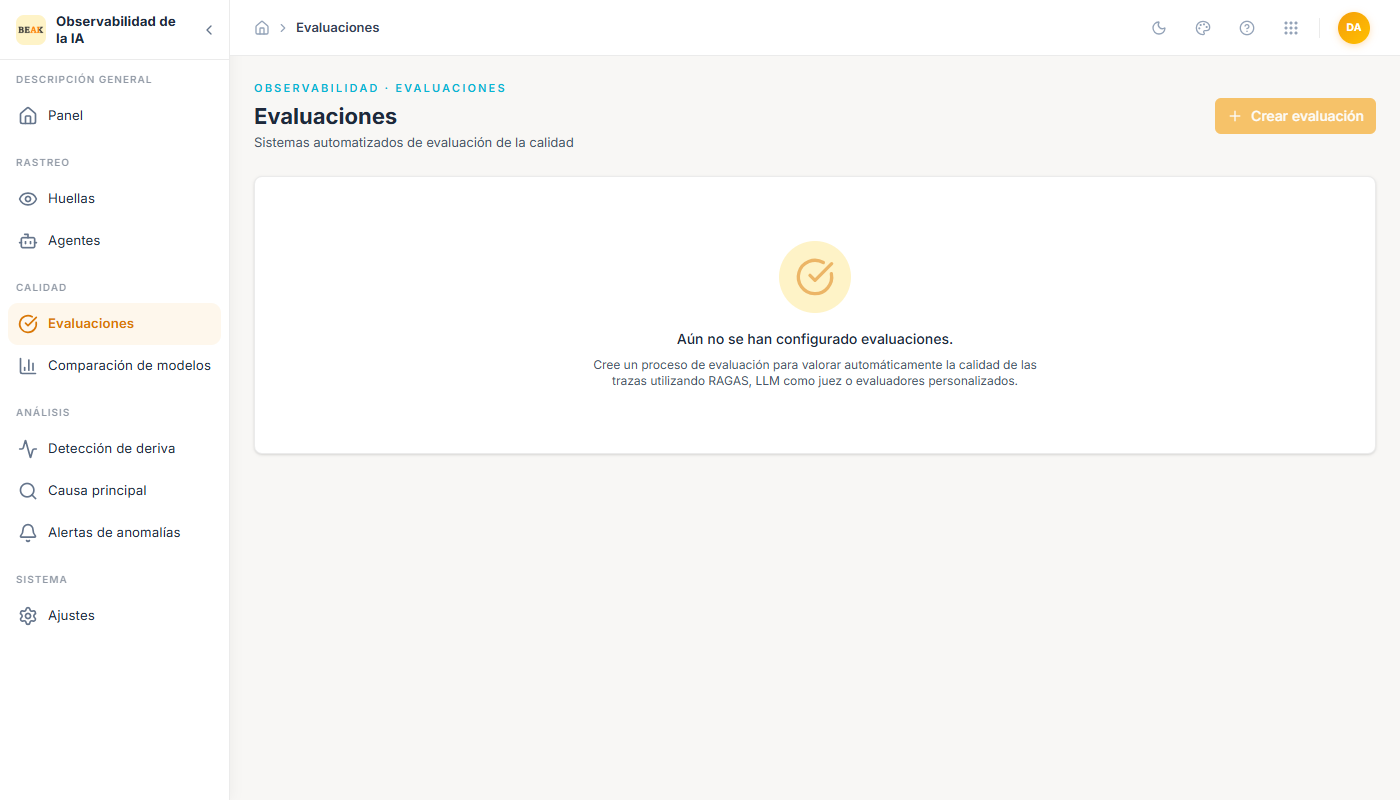
Las evaluaciones son la capa de calidad automatizada sobre los trazos. En lugar de revisar las respuestas manualmente, usted configura un pipeline que puntúa cada nuevo trazo en una o más dimensiones de calidad, y la página de Evaluaciones muestra agregados, puntuaciones por trazo e historial completo de ejecuciones.
Familias de Evaluadores
Se admiten tres familias de evaluadores de forma predeterminada:
- RAGAS — Retrieval-Augmented Generation Assessment. Puntúa
faithfulness,answer relevance,context precisionycontext recallpara cualquier trazo que incluya un paso de recuperación. Es la opción más adecuada para agentes de base de conocimientos y RAG. - LLM-as-a-judge — Un LLM configurado evalúa la respuesta del asistente según una rúbrica que usted proporciona. Funciona para cualquier trazo; resulta útil cuando la calidad no puede reducirse a métricas estilo RAGAS.
- Evaluadores personalizados — Evaluadores arbitrarios basados en Python o en prompts, registrados contra una forma de trazo. Se utilizan para métricas específicas del dominio (por ejemplo,
matches expected function signature,follows company tone guide).
Crear una Evaluación
Haga clic en + Create Evaluation en la parte superior derecha. El formulario del pipeline captura:
- Nombre / descripción — Identificador que se muestra en la lista.
- Familia de evaluador — RAGAS, LLM-as-a-judge o Personalizado.
- Dataset — Qué trazos puntuar. Las opciones incluyen todos los trazos nuevos, un Dataset guardado, o un subconjunto filtrado por agente o modelo.
- Métricas — Las dimensiones específicas que emitirá el evaluador. Depende de la familia seleccionada.
- Programación — Ejecución al ingerir (puntúa cada nuevo trazo) o bajo demanda (se activa desde la página de Evaluaciones).
Nota: El botón Create Evaluation está restringido por el rol del tenant. Cuando aparece atenuado, el usuario autenticado actualmente no tiene permiso para gestionar pipelines de evaluación; solicite a un administrador del espacio de trabajo que realice la creación o que le asigne el rol correspondiente.
Interpretación de los Resultados de Evaluación
Una vez que un pipeline está en ejecución, cada trazo en el visor de Traces adquiere una franja de Evaluaciones encima del árbol de spans que muestra las puntuaciones de cada pipeline que se ejecutó sobre él. La página de Evaluaciones agrega dichas puntuaciones:
- Resúmenes por pipeline — Media, p50 y p95 para cada métrica en la ventana de tiempo seleccionada.
- Desglose por agente — Puntuaciones agrupadas por el agente que produjo el trazo.
- Tendencia de puntuaciones — Serie temporal de cada métrica; útil para detectar regresiones tras un cambio de prompt.
Buenas Prácticas
- Ejecute RAGAS únicamente en agentes RAG. Ejecutarlo en trazos sin spans de recuperación produce puntuaciones con ruido que no son accionables.
- Para LLM-as-a-judge, mantenga la rúbrica breve y concreta (
1–5 score with one-line criterion per point). Las rúbricas largas aumentan la varianza y el costo del juez. - Los evaluadores personalizados son la opción adecuada para comprobaciones binarias (firmas de funciones, adherencia a esquemas). Prefiera reglas deterministas en lugar de jueces LLM siempre que sea posible.
- Combine las Evaluaciones con Anomaly Alerts sobre las puntuaciones emitidas — una caída en faithfulness es un precursor rápido de regresiones de calidad visibles para el usuario.