Alertas de Anomalías
Las Alertas de Anomalías se activan cuando una métrica de la flota supera un umbral configurado. El detector utiliza detección de anomalías basada en puntuación Z sobre el flujo continuo de trazas, lo que lo hace sensible a cambios repentinos sin generar ruido ante la varianza normal del día a día.
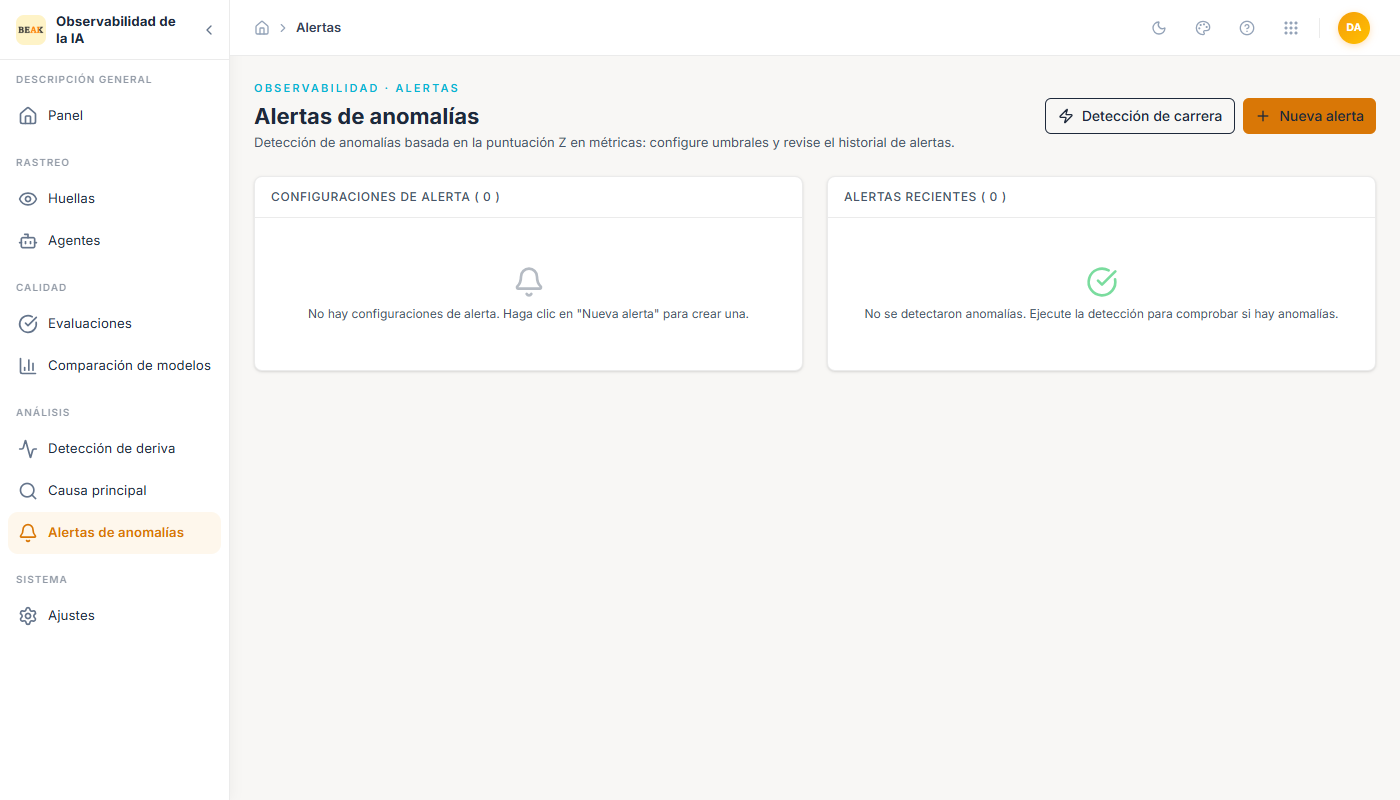
La página se divide en dos regiones:
- Configuraciones de Alerta — Los umbrales que ha configurado. Cada configuración vincula una métrica, una condición y un umbral.
- Alertas Recientes — El registro de alertas activadas, cada una con una severidad (
critical·warning), el valor de la métrica que superó el umbral y el agente que lo incumplió.
Dos acciones principales se encuentran en la parte superior derecha: Run Detection (fuerza una evaluación inmediata contra las métricas actuales) y + New Alert (crea un nuevo umbral).
Crear una Alerta
Al hacer clic en + New Alert se muestra un formulario de configuración en línea.
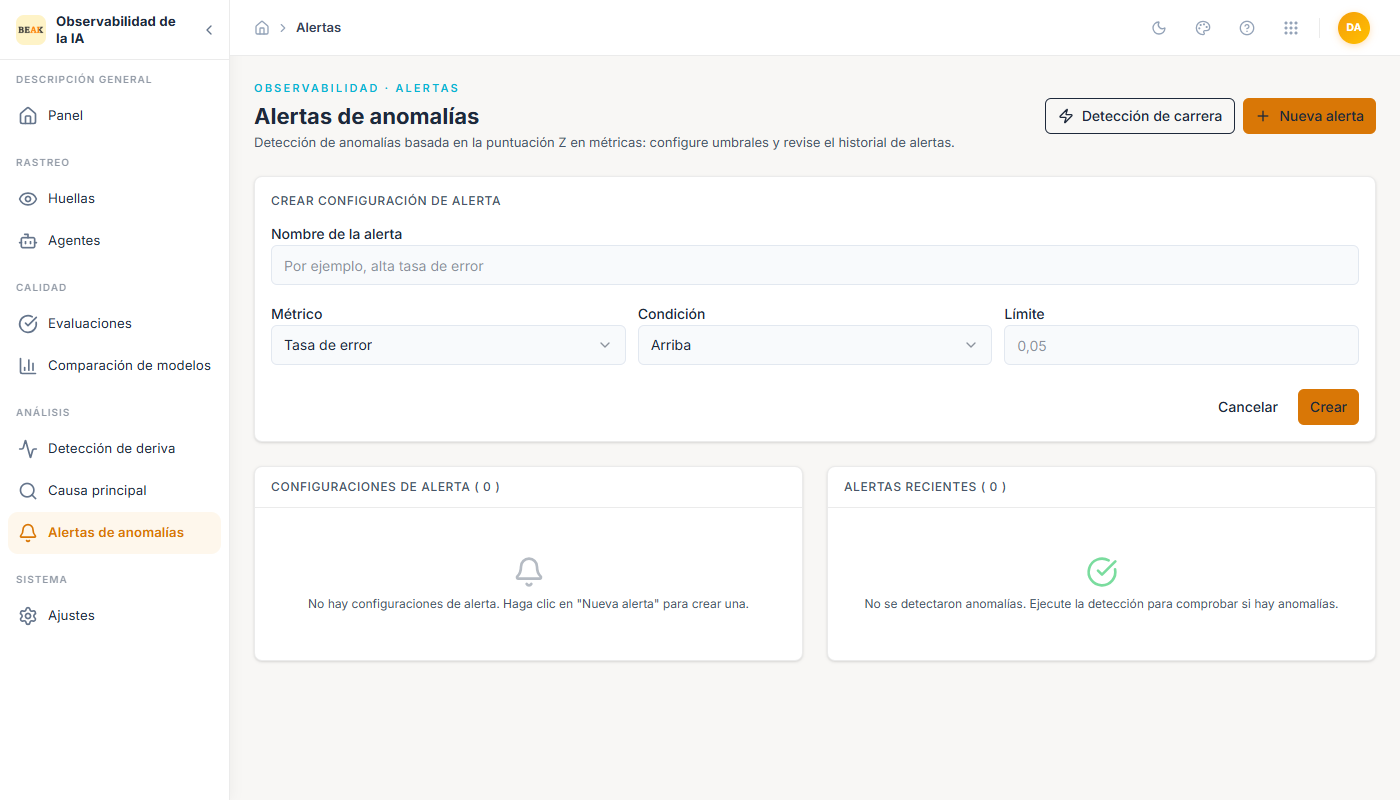
- Alert Name — Identificador legible por personas (p. ej.
High error rate). - Metric — Una de las siguientes:
Error RateP95 LatencyCostThroughput
- Condition —
AboveoBelow. - Threshold — Valor numérico que la métrica debe superar para activarse.
Haga clic en Create para guardar. La nueva configuración aparece bajo Configuraciones de Alerta y comienza a evaluarse en el próximo ciclo de detección.
Interpretar las Alertas Recientes
Cada fila en Alertas Recientes muestra:
- Indicador de severidad —
critical(rojo) owarning(ámbar), determinado por la magnitud de la puntuación Z. - Título — La métrica que se activó y el agente para el que se activó (p. ej.
error_rate alert for CodeOps AI). - Línea de detalle — El valor observado, el umbral configurado y el identificador del agente (p. ej.
Error Rate: 0.15 (threshold: 0.05) — Agent: agent-codeops-002). - Marca de tiempo — Cuándo se activó la alerta.
Al hacer clic en una fila (cuando es compatible) se abre la vista de Trazas filtrada correspondiente para que pueda inspeccionar las trazas que contribuyeron al incumplimiento.
Buenas Prácticas
- Mantenga un conjunto reducido de alertas de alta señal en lugar de una larga lista de alertas de baja señal. Cuatro alertas — una sobre Error Rate, una sobre P95 Latency, una sobre Cost y una sobre Throughput — cubren la mayoría de las regresiones en producción.
- Establezca los umbrales por encima de la varianza máxima normal, no en la media. Un umbral en la media se activará constantemente; un umbral 2σ por encima del pico se activa cuando algo está genuinamente mal.
- Combine las Alertas de Anomalías con Root Cause. Cuando
error_rateactivecritical, ejecute un RCA de inmediato para que el clúster quede resumido mientras el incidente está en curso. - Use Run Detection después de ajustar un umbral para confirmar que el nuevo valor no genera activaciones retroactivas contra el historial reciente.