Enrutamiento
El enrutamiento configura cómo el Gateway selecciona un modelo cuando hay más de uno elegible, cuánto tiempo se excluye del grupo un modelo con fallos, qué modelos de respaldo se intentan tras los fallos y con qué intensidad el Gateway reintenta antes de rendirse.
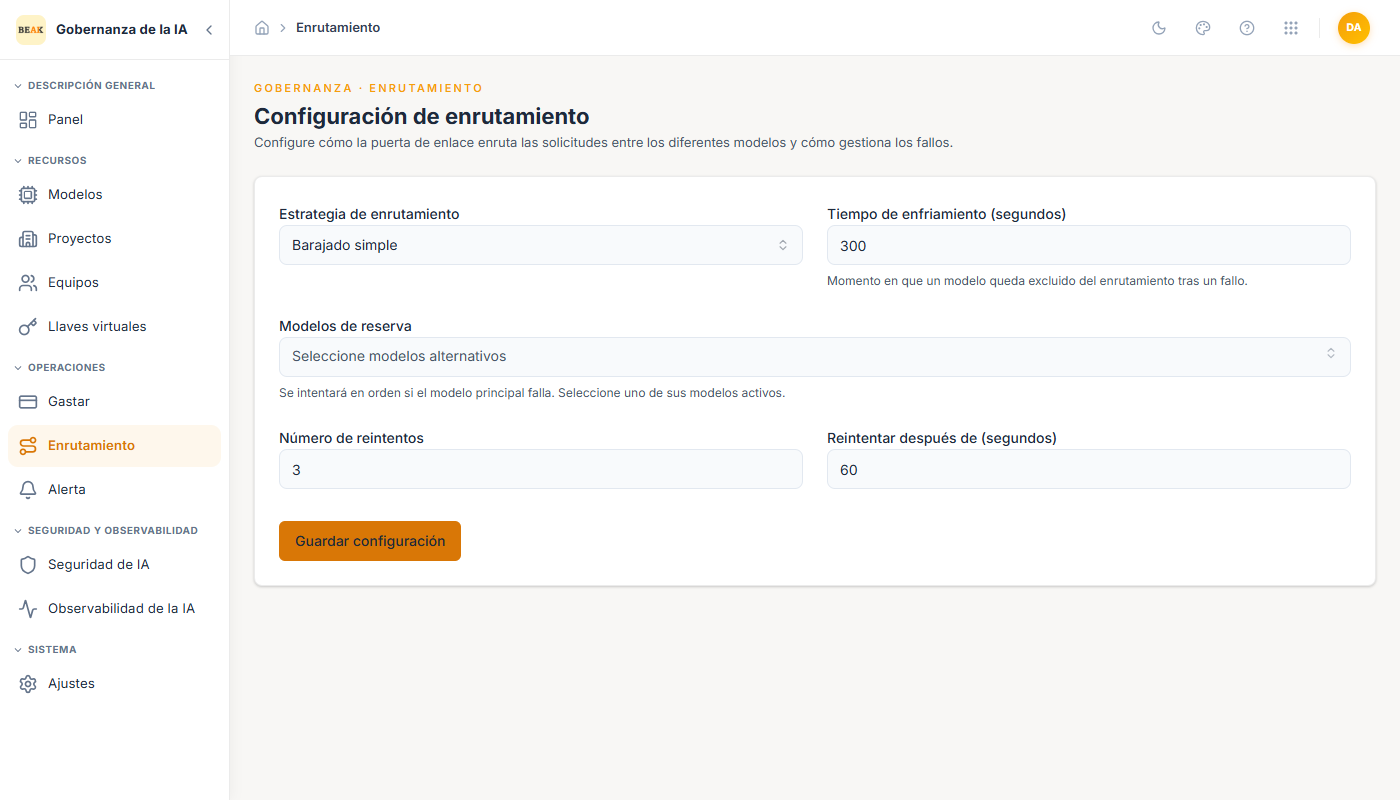
Todos los valores de esta página son globales: se aplican a cada equipo y cada solicitud a menos que se sobrescriban a nivel de equipo. Haga clic en Save Configuration para guardar.
Estrategia de Enrutamiento
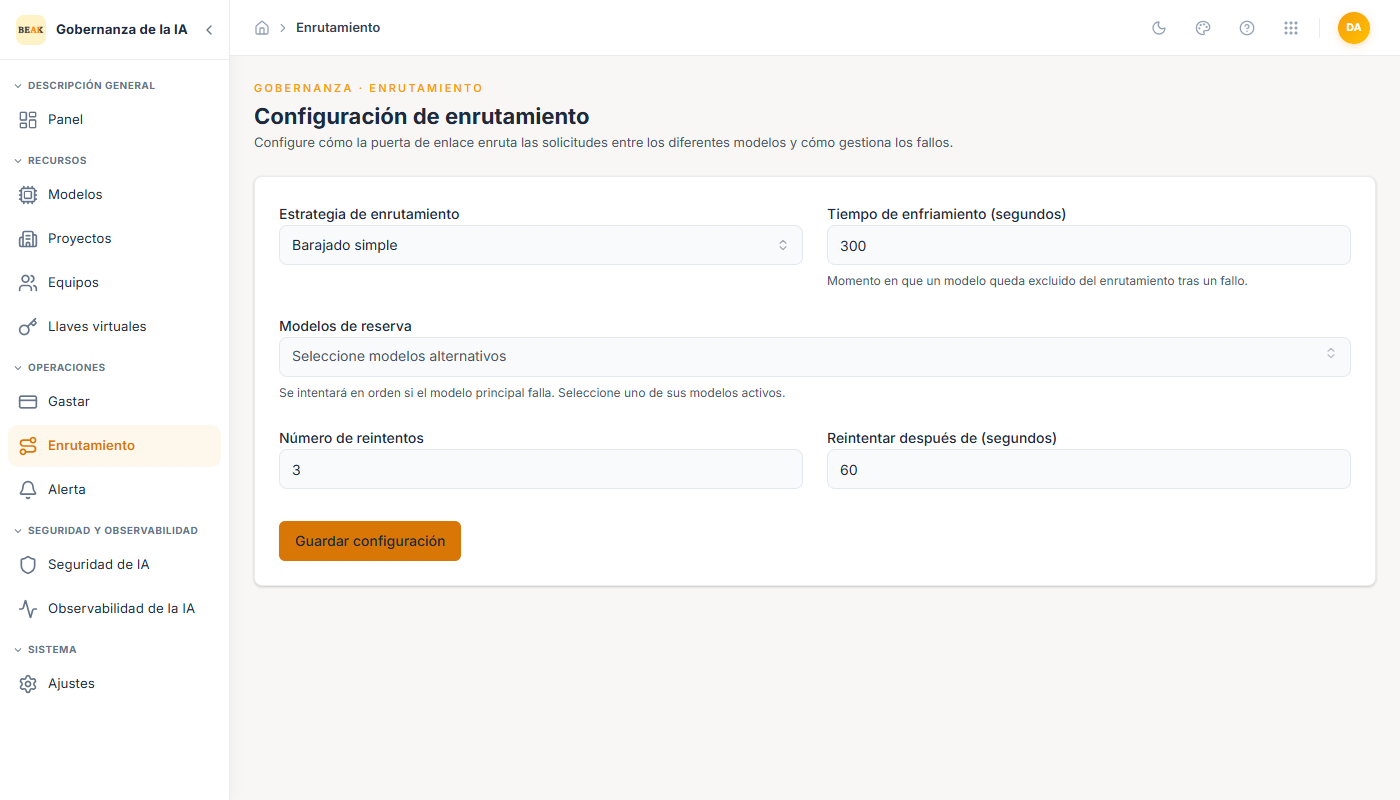
Se admiten cinco estrategias:
- Simple Shuffle (predeterminada) — Turno rotativo entre los modelos elegibles. La más justa, la más sencilla y la opción predeterminada adecuada cuando los modelos son intercambiables.
- Least Busy — Selecciona el modelo con menos solicitudes en curso. Ideal cuando los modelos tienen límites de concurrencia asimétricos.
- Latency Based — Selecciona el modelo con la latencia P95 reciente más baja. Útil cuando los proveedores tienen diferencias de rendimiento regional que varían con el tiempo.
- Cost Based — Selecciona el modelo más económico por solicitud. Adecuado para cargas de trabajo por lotes o de baja prioridad.
- Usage Based — Prefiere el modelo que está más lejos de su límite de TPM/RPM. Distribuye el tráfico de manera uniforme en una flota heterogénea.
La estrategia solo resuelve la ambigüedad entre modelos que son a la vez elegibles (lista de permitidos del equipo) y saludables (no en tiempo de espera). Consulte Balanceo de Carga para conocer cómo interactúan las estrategias con las comprobaciones de estado.
Tiempo de Espera (Cooldown)
Cuando un modelo falla (5xx del proveedor, tiempo de espera agotado, límite de velocidad del lado del proveedor), el Gateway lo excluye del enrutamiento durante el Tiempo de Espera (segundos) configurado. El valor predeterminado es 300 segundos. Los tiempos de espera más cortos recuperan más rápido, pero pueden generar inestabilidad ante un proveedor parcialmente degradado; los tiempos más largos estabilizan el enrutamiento, pero mantienen capacidad fuera de línea durante incidentes reales.
Modelos de Respaldo
Una lista separada por comas de nombres de pantalla (Display Names) de modelos que el Gateway intenta cuando todos los modelos elegibles de la lista de permitidos del equipo están en tiempo de espera. La lista de respaldo es global: se activa independientemente del equipo que haya realizado la solicitud, así que mantenga las entradas con utilidad amplia (p. ej., gpt-4o, claude-3-opus).
Reintentos
- Número de reintentos — Cuántas veces reintenta el Gateway una única solicitud antes de devolver el error al solicitante. El valor predeterminado es 3.
- Reintento tras (segundos) — Espera entre reintentos. El valor predeterminado es 60 segundos.
Los reintentos se contabilizan a lo largo de toda la cadena de respaldo: una solicitud que falla en el Modelo A, reintenta y falla en el Modelo B, y luego tiene éxito en el Modelo C consume dos reintentos.
Buenas Prácticas
- Comience con
Simple Shuffle. Es la estrategia más segura y aquella en la que cualquier regresión será más evidente. - Mantenga el
Cooldown Timeen 300 segundos a menos que tenga evidencia de interrupciones frecuentes. Los valores más cortos dificultan el análisis post-mortem de incidentes. - Use
Fallback Modelscomo salida de emergencia, no como política de reducción de carga. Si los respaldos se activan de forma rutinaria, escale el grupo primario en su lugar. - Nunca establezca el
Number of Retriespor encima de 5. Los tiempos de espera del lado del agente no están diseñados para cadenas largas de reintentos, y los reintentos adicionales generalmente se manifiestan como una experiencia de usuario lenta en lugar de tasas de éxito mejoradas.