Balanceo de Carga
El balanceo de carga en Beak AI Gateway es la ejecución de la configuración de Enrutamiento en el momento de la solicitud. El Gateway selecciona un modelo de la lista de permitidos del equipo, respeta la estrategia de enrutamiento configurada, tiene en cuenta el estado de salud del modelo y realiza retrocesos o reintentos según la política — todo antes de que la solicitud salga del Gateway.
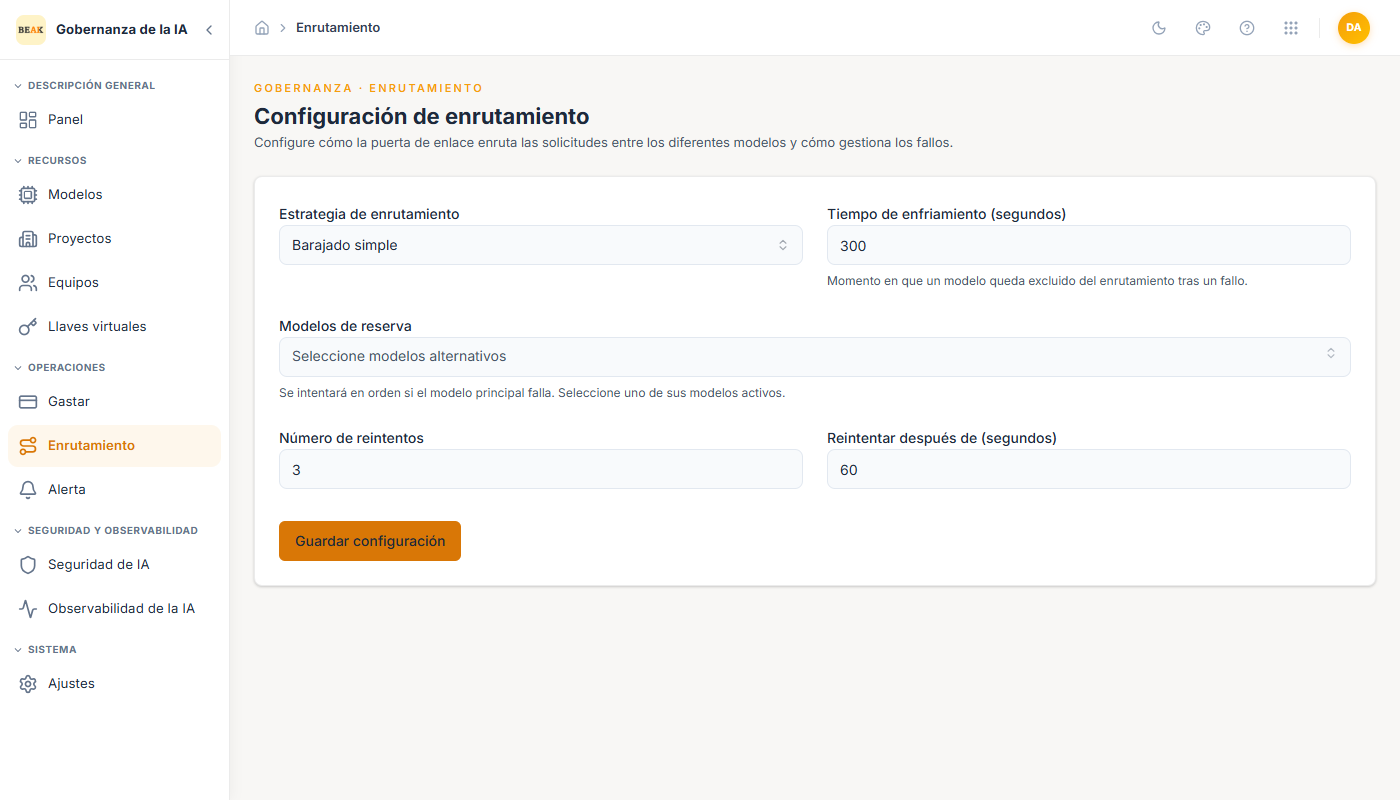
Orden de Selección
Para cada solicitud entrante, el Gateway resuelve un modelo en este orden:
- Lista de permitidos del equipo — Solo se consideran los modelos que el equipo tiene permiso para llamar.
- Verificación de salud — Los modelos que actualmente están en periodo de enfriamiento (tras un fallo reciente) quedan excluidos.
- Coincidencia de tipo — Para solicitudes
/chat/completions, solo califican los modelosChat; para/embeddings, solo los modelosEmbedding, etc. - Estrategia de enrutamiento — Aplica la estrategia (Simple Shuffle, Least Busy, Latency Based, Cost Based, Usage Based) para seleccionar un modelo del grupo filtrado.
Si el grupo está vacío — todos los modelos elegibles están en enfriamiento — el Gateway intenta con la lista global de Fallback Models. Si eso también falla, se aplica la política de reintentos.
Control de Salud
Cada modelo mantiene una pequeña ventana de salud. Un fallo (5xx del proveedor, tiempo de espera agotado, límite de tasa del lado del proveedor) excluye al modelo del enrutamiento durante Cooldown Time segundos. Durante el enfriamiento, el Gateway vuelve a sondear con un pequeño flujo de tráfico para que un proveedor en recuperación pueda volver a estar en línea sin esperar toda la ventana.
Cadena de Conmutación por Error
En caso de fallo durante una solicitud, el Gateway:
- Lo contabiliza contra el presupuesto de reintentos de la solicitud.
- Espera
Retry Aftersegundos. - Vuelve a entrar en el orden de selección excluyendo el modelo fallido.
- Selecciona el siguiente mejor modelo y reintenta.
Si la lista de permitidos del equipo se agota, el Gateway recurre a la lista de Fallback Models. Si esta también se agota, la solicitud falla y el último error del proveedor se muestra al solicitante.
Interacción con los Límites de Tasa del Equipo
Los límites de TPM y RPM del equipo se aplican en el perímetro del Gateway, antes del enrutamiento. Una solicitud que supere el presupuesto o el límite de tasa del equipo es rechazada inmediatamente con un 429 — nunca llega a la capa de enrutamiento. Esto evita que un equipo con alto volumen consuma espacios de enfriamiento en nombre de equipos con menor actividad.
Buenas Prácticas
- Mantenga la estrategia de enrutamiento coherente con la carga de trabajo del equipo.
Cost Basedno es adecuado para un agente de chat orientado al usuario;Latency Basedno es adecuado para un trabajo por lotes. - Supervise
Cooldown Time× tasa de fallos. Si la mitad de la flota está en enfriamiento la mitad del tiempo, el problema real es la inestabilidad del proveedor — ninguna estrategia de enrutamiento puede resolver eso. - Dimensione
Fallback Modelspara cubrir fallos catastróficos de los proveedores principales, no interrupciones ordinarias. La cadena de conmutación por error es una red de seguridad, no un plan de capacidad.