Monitor de Aplicaciones
El Monitor de Aplicaciones de Beak NOC extiende la observabilidad de red hasta la capa de aplicación. En lugar de supervisar únicamente dispositivos y enlaces, el Monitor de Aplicaciones rastrea endpoints HTTP, REST APIs y aplicaciones web desde el exterior hacia el interior — midiendo disponibilidad, tiempo de respuesta, estado del certificado SSL y el éxito de las transacciones sintéticas.
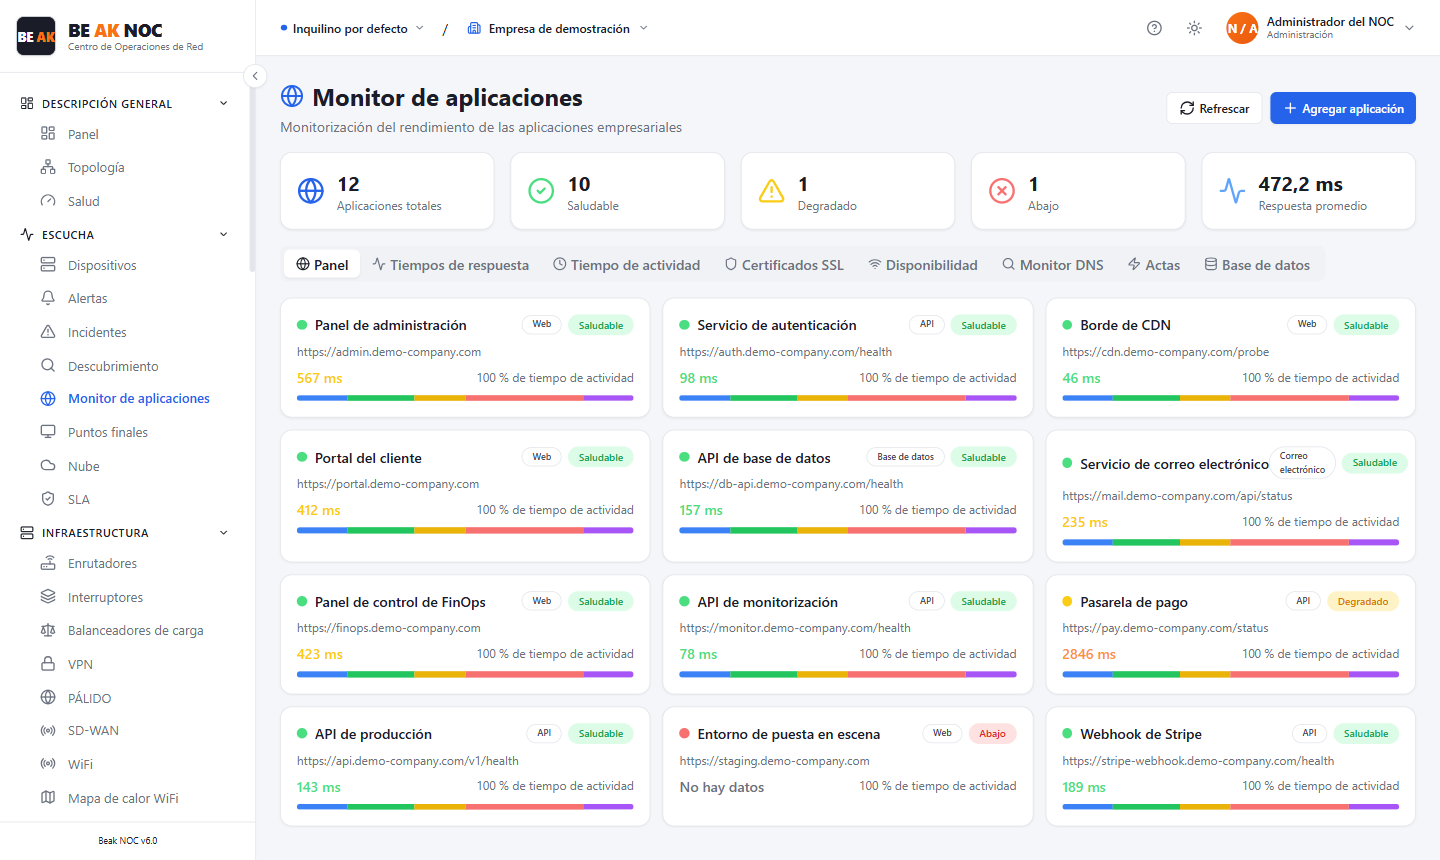
Descripción General
El Monitor de Aplicaciones funciona enviando sondas HTTP/HTTPS sintéticas a los endpoints de aplicación registrados en intervalos configurables. Estas sondas miden:
- Disponibilidad — ¿La aplicación devuelve una respuesta HTTP exitosa (2xx)?
- Tiempo de Respuesta — ¿Cuánto tarda la aplicación en responder (en milisegundos)?
- Estado del Certificado SSL — ¿El certificado es válido y no está próximo a expirar?
- Éxito de la Transacción — ¿Las transacciones sintéticas de múltiples pasos se completan de extremo a extremo?
Esto proporciona visibilidad del SLA a nivel de aplicación que la supervisión de red pura no puede ofrecer — una red puede estar completamente saludable mientras una aplicación devuelve errores 500.
Tarjetas de Resumen
| Tarjeta | Descripción |
|---|---|
| Total de Apps | Recuento de aplicaciones registradas para supervisión |
| Saludables | Aplicaciones que devuelven respuestas exitosas dentro de los umbrales de tiempo de respuesta |
| Degradadas | Aplicaciones que responden pero superan los umbrales de tiempo de respuesta |
| Caídas | Aplicaciones que no responden o devuelven códigos de estado de error |
| Respuesta Prom. | Tiempo de respuesta promedio en todas las aplicaciones saludables (en ms) |
Pestañas del Panel
Pestaña Panel
La vista predeterminada muestra una tarjeta de resumen de estado para cada aplicación supervisada — con código de color por estado (verde/ámbar/rojo) con el tiempo de respuesta actual y el porcentaje de disponibilidad.
Pestaña Tiempos de Respuesta
Un gráfico de series de tiempo que muestra las tendencias del tiempo de respuesta de todas las aplicaciones supervisadas durante el intervalo de tiempo seleccionado. Úselo para identificar:
- Degradación del rendimiento — Una aplicación que era rápida ayer pero es lenta hoy
- Patrones por hora del día — Carga máxima durante el horario laboral que provoca picos en el tiempo de respuesta
- Ralentizaciones correlacionadas — Múltiples aplicaciones que se ralentizan simultáneamente (puede indicar un problema de infraestructura compartida)
Pestaña Disponibilidad
El seguimiento de disponibilidad muestra el porcentaje de disponibilidad de cada aplicación durante el período seleccionado (diario, semanal, mensual). Compare la disponibilidad con los SLA contractuales o los objetivos internos.
Pestaña Certificados SSL
Lista los certificados SSL/TLS de todos los endpoints de aplicación supervisados con:
| Columna | Descripción |
|---|---|
| Host | Nombre de host de la aplicación |
| Vence | Fecha de vencimiento del certificado |
| Días Restantes | Días hasta el vencimiento — con código de color (rojo = vencido/inminente, ámbar = <30 días, verde = válido) |
| Protocolo | Versión de TLS en uso |
Pestaña Transacciones
Las transacciones sintéticas de múltiples pasos simulan la interacción real de un usuario con una aplicación — por ejemplo, iniciar sesión, enviar un formulario o completar un flujo de pago. Cada paso se supervisa individualmente para que los fallos puedan identificarse en el paso exacto donde ocurrieron.
Agregar una Aplicación
Haga clic en Agregar Aplicación para registrar una nueva aplicación para supervisión. Configure:
- Nombre — Etiqueta descriptiva (p. ej.,
Beak Portal - Login) - URL — La URL del endpoint a sondear (p. ej.,
https://portal.beakops.com/login) - Método — Método HTTP (
GET,POST, etc.) - Intervalo — Con qué frecuencia sondear (p. ej., cada 60 segundos)
- Tiempo de espera — Tiempo de respuesta máximo aceptable antes de marcar como degradada
- Código de Estado Esperado — El código de estado HTTP considerado exitoso (predeterminado: 200)
- Umbrales de Alerta — Tiempo de respuesta y recuentos de fallos consecutivos que activan alertas
Mejores Prácticas
- Supervise tanto el frontend como el backend — Agregue la URL orientada al usuario y cualquier endpoint de API crítico por separado para identificar si los fallos son de la capa UI o de la capa API.
- Establezca umbrales de tiempo de espera realistas — Un tiempo de espera de 5 segundos es razonable para una página web; un tiempo de espera de 500 ms es apropiado para un endpoint de API.
- Use transacciones sintéticas para rutas críticas — Supervise el flujo de inicio de sesión, no solo la página de inicio — una página de autenticación rota tiene más impacto que una página estática lenta.
- Correlacione con alertas de red — Cuando una aplicación cae, consulte Alertas para determinar si la causa es la propia aplicación o un problema de red más amplio.
Páginas Relacionadas
- Alertas — La caída y degradación de aplicaciones activa alertas de red
- SLA — La disponibilidad de aplicaciones se integra en el seguimiento general del cumplimiento del SLA
- Seguridad — La supervisión de certificados SSL también está disponible en la pestaña SSL/TLS del SOC
- Informes — Los datos de disponibilidad de aplicaciones se incluyen en los informes de resumen ejecutivo